更新日:2026年8月19日
15分で読めます
履歴をすべて取得するクローンが、開発基盤全体にコストを課している
リポジトリに置いたTOMLファイルだけで、シャロークローンや部分クローンといった最適化を自動適用。Git Clone Override Policyがサーバー負荷とコストを削減する仕組みを解説します。
git clone はクライアント側の操作だと思われがちですが、その設定はサーバー側と、その間にあるすべてのネットワークにまで影響します。デフォルトのフル履歴クローン(履歴をすべて取得する通常のクローン)を実行すると、サーバーは履歴全体をたどってパックファイルを構築し(「counting objects」が実際に行っているのはこの処理です)、ネットワーク越しに送り出します。クライアント側はそれをすべて展開し、完全なワークツリーをチェックアウト。クライアントのCPU、ネットワーク、Gitサーバーのパック構築処理、ディスクと、あらゆるレイヤーがそのリクエストの大きさに応じたコストを負担しています。逆に言えば、リクエストを小さくすれば、手元のノートPCだけでなくスタック全体のコストが一度に下がるということです。
エージェント型AIは、通常の開発ワークフローとは比べものにならない負荷をこの部分にかけます。リポジトリを扱うエージェントは、人間よりもはるかに高い頻度で、しかも予測しにくいタイミングでクローンを実行。デフォルトがフル履歴クローンのままなら、そのコストをエージェントの規模で払い続けることになるのです。
GitLabは、大規模リポジトリをより高速に配信できるよう、バックエンドの改善に力を入れています。一方で、リクエストする側の内容を変えるという手もあります。シャロークローン(--depth=1)、単一ブランチのクローン、部分クローン(--filter=blob:none)を使えば、ジョブが実際に必要とするものだけを取得可能。リクエストを絞り込むだけで、ピーク時の負荷、不安定さ、待ち時間、コストがその場で下がります。しかも今後のバックエンド改善は、この軽量化されたリクエストの上に積み重なっていくのです。
以前の記事「Gitワークフローを高速化」では、Git Much Faster がどのようにベンチマークを行い、クローン時間を最大93%、ディスク使用量を最大98%削減する設定を割り出したかを解説しました。圧縮の無効化、HTTPバッファの拡大、シャロークローンと部分クローン、バイナリをスキップするスパースチェックアウト。数字としては申し分ありません。ただし、落とし穴がひとつ。リポジトリをクローンするすべての場所に、何行もの最適化コードを漏れなく反映させる必要があるのです。デベロッパーのノートPC、CIジョブ、サンドボックスを立ち上げるエージェント。そのどれもが、設定を忘れる機会になり得ます。
これは自動化ではありません。ただの願望です。
本記事では、リポジトリのクローン最適化を自動的に適用し、コストを最小化するGit Clone Override Policyの導入方法を解説します。
クローンのコストが最も重くのしかかる場所
エージェント型AIは最も新しく、最も急速に拡大している圧力ですが、デフォルトのフル履歴クローンがソフトウェア業界に大きな代償を強いている場面は、ほかにもあります。
- モノレポ: 多数のプロジェクトを1つのリポジトリに集約すると、クローンのたびに、個々のチームが実際に必要とする量をはるかに超えるデータを取得することになります。
- 複雑で長期にわたるGit履歴: 現在のツリーが小さくても、何年分ものコミットが積み重なることでリポジトリ全体のサイズは膨らみます。
- メディア、バイナリ、組み込みプロジェクト: ファームウェアイメージ、ベンダー提供のSDK、デザインアセットをバージョン管理に直接格納すると、ソースコードだけでは起こり得ない規模でリポジトリが肥大化します。
- CI/CDパイプライン: ジョブごとに新規クローンが走り、それが1日に数千回繰り返されれば、1回あたりのわずかな非効率が大きな継続コストに変わります。
- データサイエンスと機械学習のデータセット: Gitで管理される大きなデータファイルも、サイズの大きいほかのblobと同じコストを抱えています。
- リモート開発環境: クラウド上の環境や一時的な開発環境は、高速で軽量な起動を求めながら、実際にはリポジトリ全体の複製がデフォルトのままです。
- エージェント型AI: クローン要求の数は大幅に増え、しかも人間主導のワークフローよりはるかに予測しにくくなります。
最適化をスキップできない仕組みにする
解決策は、どのフラグを設定すべきかを説明するREADMEを充実させることではありません。判断そのものを個人の手から完全に切り離すこと。つまり、ポリシーをコードとしてリポジトリ自体にコミットし、小さなプログラムに強制させるという方法です。
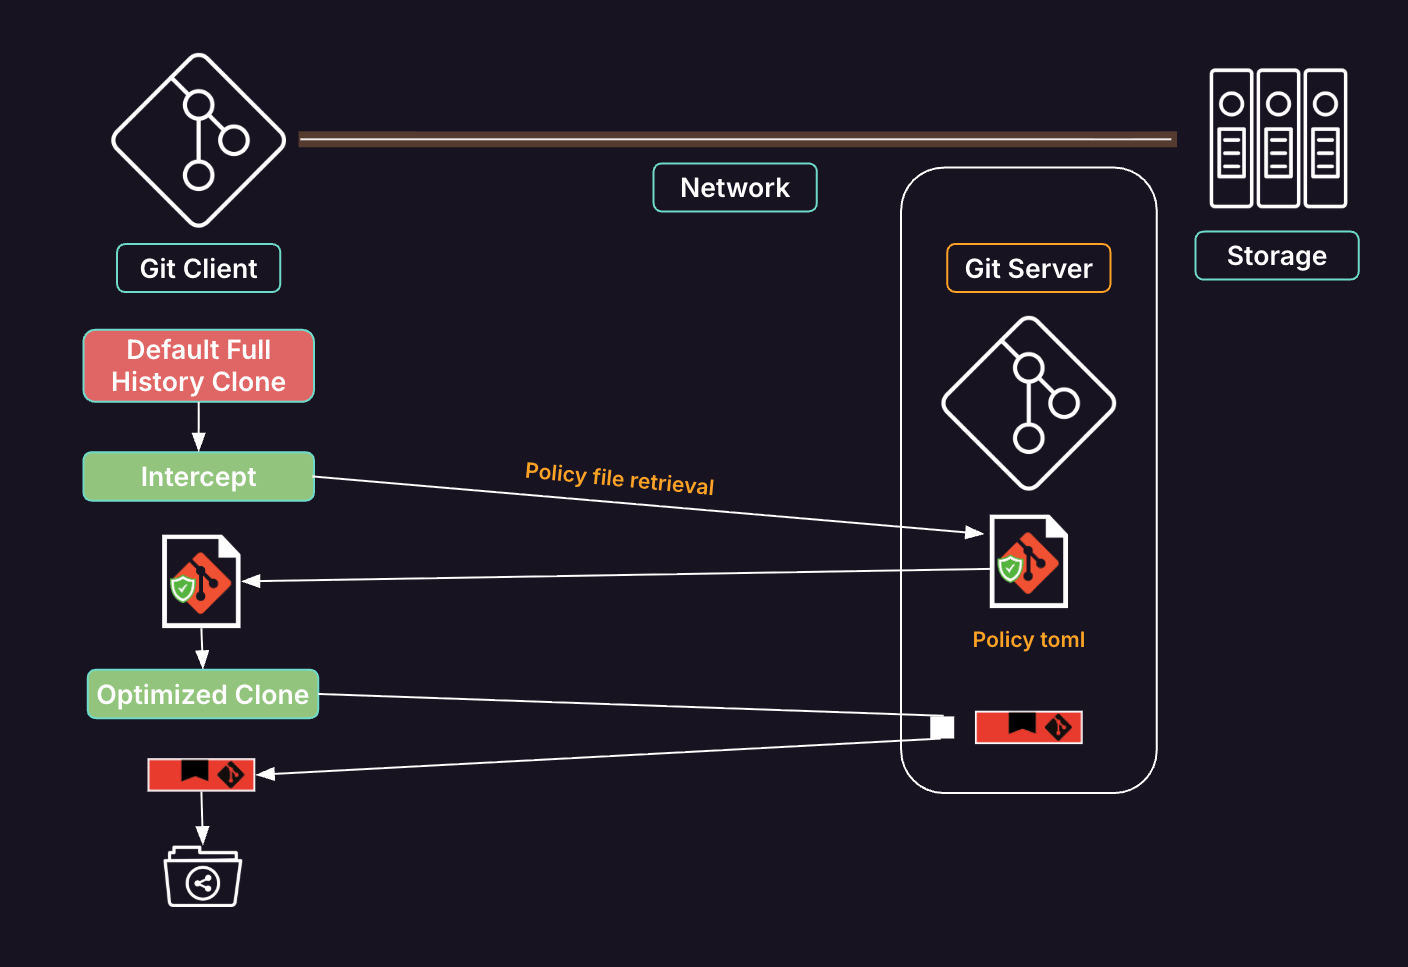
それを実現するのが Git Clone Override Policy です。リポジトリに .afullhistorycloneoverridepolicy.toml ファイルを置くと、軽量なGoバイナリが、オプションを一切付けない git clone URL(素のまま、デフォルトのフル履歴リクエスト)だけを横取りします。ユーザー自身が何らかのオプション(--depth 1、--filter など)を付けた時点で、バイナリは「すでに最適化している」と判断し、コマンドをそのまま素通し。リポジトリにポリシーファイルがない場合も同じで、通常のクローンへのクリーンなパススルーとなります。介入するのは、誰もが間違いだと認める唯一のケース、つまり条件を何も指定しないデフォルトの場合だけです。
実際に介入する場合の流れはこうです。まずポリシーファイルを取得し、続いて13ステップの固定処理を実行します。この処理では、リポジトリをシャロークローンかつ部分クローンで取得し、バイナリファイル(画像、アーカイブ、メディア、フォントなど)をスキップするスパースチェックアウトを設定し、Git Much Fasterと同じチューニング済みgit configを適用。これらはすべて、ソースコードが1行でもディスクに現れる前に完了します。
最大限に最適化するとどうなるか
Gitのクローンを最大限に最適化するために必要なコマンドを見ていきましょう。
1. git clone を使わず、リポジトリの器を自分で作る
こうすることで、最初のクローンリクエストのファイル範囲を決める、さまざまなgit設定を適用できます。
      mkdir my-repo && cd my-repo
git init
git remote add origin https://example.com/group/my-repo.git
2. このリポジトリだけにスコープを限定し、大容量転送向けにgit configをチューニングする
      git config --local core.compression 0
git config --local http.postBuffer 1024M
git config --local http.lowSpeedLimit 1000
git config --local http.lowSpeedTime 300
git config --local pack.windowMemory 256m
git config --local pack.packSizeLimit 256m
git config --local pack.threads 4
3. --filter でフェッチするため、部分クローンを有効にする
      git config --local extensions.partialClone origin
git config --local remote.origin.promisor true
git config --local remote.origin.partialclonefilter blob:none
4. リモートの全ブランチではなく、実際に必要な1つのrefだけにフェッチのrefspecを絞り込む
git config --local remote.origin.fetch "+refs/heads/main:refs/remotes/origin/main"
この設定を変更しない場合、remote.origin.fetch には自動的に +refs/heads/*:refs/remotes/origin/* が設定されます。つまり、フェッチのたびに(そして最初のクローン時にも)originにあるすべてのブランチのrefポインタを取得することになるわけです。この設定を書き換えれば、フェッチ対象を main ブランチだけに限定でき、Gitはそれ以外のリモートブランチのrefを追跡も更新もしなくなります。
ネゴシエーションと更新の対象となるrefが減るため、フェッチ1回あたりのオーバーヘッドも小さくなります。ブランチが数百に及ぶリポジトリでは、その差は特に顕著です。
5. blobの取得を先送りしつつ、シャローにフェッチする
git fetch --depth=1 --filter=blob:none origin main
depthとfilterのこの組み合わせにより、初回転送を最小限に抑えられます。取得されるのはコミット1つ分のツリー構造だけで、ファイルをチェックアウトするまでblobデータは一切ダウンロードされません。この効果が特に大きいのは、大きなファイルや長い履歴を抱えるリポジトリを扱う場合です。
6. スパースチェックアウトを有効にし、ソース作業に不要なバイナリファイル形式をすべて除外する
      git sparse-checkout init --cone
cat >> .git/info/sparse-checkout <<'EOF'
/*
!*.png
!*.PNG
!*.jpg
!*.JPG
!*.pdf
!*.PDF
!*.zip
!*.ZIP
!*.mp4
!*.MP4
!*.exe
!*.EXE
EOF
実際のポリシーでは、画像、ドキュメント、アーカイブ、メディア、コンパイル済みバイナリ、デザインファイルにわたる30種類以上の拡張子を、大文字・小文字の両方で除外しています。上記はその一部を抜き出したものにすぎません。
7. refをチェックアウトする
git checkout main
この7段階をこの順番どおりに www.gitlab.com に対して実行すれば、9.5GBではなく110MBに収まります。順番を間違えると(refspecを絞る前にフェッチする、スパースチェックアウトをチェックアウトの前ではなく後に行う、など)、よくて最適化が無駄になり、最悪の場合は取得を避けようとしていたものをそのまま取得してしまいます。この正確さを、すべての人とすべてのパイプラインが、クローンのたびに正しく繰り返す。冒頭で触れた規律の問題とは、まさにこれです。Git Clone Override Policyは、ここで新しい技術を発明しているわけではありません。誰も手順を覚えていなくても、この7段階が毎回同じ順序で確実に実行されることを保証する。それがこのツールの役割です。
自動化という解決策
Gitクライアントの利用は規模が大きく、しかも分散しています。そのため、目的に応じた正確なクローン最適化コマンド一式を、人が手で実行したり、CIジョブやエージェントのサンドボックスごとに個別実装したりする方法では、真の信頼性は得られません。ここで必要になるのが自動化です。
全員が7つの段階を記憶していることに賭けるのではなく、自動的なポリシーでこのワークフローを強制できるとしたらどうでしょうか。実は、それをそのまま実現する実装がすでに存在します。コードと並んでリポジトリに置かれるTOMLポリシーファイルと、すべての git clone 呼び出しをネットワークに届く前に横取りできるクライアントの組み合わせです。ポリシーを一度保存しておけば、人間、CIジョブ、エージェントを問わず、あらゆるクローンが依頼ベースではなく自動的に最適化された手順を通ります。ポリシー設定ファイルを使えば、用途ごとに必要なチューニングも可能。上記のデフォルトはコード行数のカウントを想定したもので、既存のテキストファイルを確実に取得できれば十分です。一方、同じソフトウェアをビルドする場合は、アプリケーションのUIに一部のグラフィックを組み込むためにより多くのファイルが必要になることもあります。リリースノート用のコミットメッセージを探すために、より多くのGit履歴情報を要するビルドもあるでしょう。
小さくポータブルなGoバイナリと、リポジトリに置くポリシー設定ファイル
インターセプター本体は、自己完結型のGoバイナリ1つです。sed と願望でつなぎ合わせたシェルスクリプトではありません。この選択には、いくつか注目すべき利点があります。
Linux、macOS、Windowsで動作し、amd64とarm64の両方に対応。bash版とPowerShell版が別々に存在して互いにずれていく、といった事態は起こりません。コードベースは1つだけです。CMDやPowerShellからGit Bash、WSLまで、遭遇しそうなシェルはひととおりテスト済み。実行時の依存は、PATH 上にある本物の git バイナリだけです。
内部構造も、すべてを1つの大きな関数で処理するのではなく、独立してテストできる6つの小さな部品に分かれています。ポリシーの解析、固定シーケンスのインタープリター、gitコマンドの実行、ロギング、クロスプラットフォーム判定、そして4つの呼び出しモードすべてを扱うエントリーポイントです。
現時点で調整できる項目の感覚をつかむには、次の設定ファイル例が参考になります。
      schema_version = 2

[policyinfo]
description = "The most optimal latest-code-only clone for AI agents (that do not need git history) or counting lines of code."
OptimalForAIAgents = true

[git_config]
"core.compression"   = 0
"http.postBuffer"    = "1024M"
"http.lowSpeedLimit" = 1000
"http.lowSpeedTime"  = 300
"pack.windowMemory"  = "256m"
"pack.packSizeLimit" = "256m"
"pack.threads"       = 4

[fetch]
flags = ["--depth=1", "--filter=blob:none"]

[sparse_checkout]
enabled  = true
# conemode 'auto' is processed by the solution code to be either 'cone' or 'no-cone' when passed to git
conemode = "auto"
includes = ["/*"]
excludes = []
exclude_extensions = [
  "png", "jpg", "jpeg", "gif", "svg", "ico", "webp",
  "pdf", "doc", "docx", "xls", "xlsx", "ppt", "pptx",
  "zip", "tar", "gz", "jar",
  "mp4", "mp3", "mov",
  "exe", "dll", "so", "woff", "woff2",
  "ttf", "otf", "psd", "sketch", "fig", "dmg", "eps",
]
case_variants = "both"
コードよりも宣言型の設定を
Infrastructure as Codeは、チームごとにばらつきがちな膨大なコードを、宣言型の設定ファイルとそれを処理するエンジンに落とし込むことで、複雑さを減らし、標準化とセキュリティを高めてきました。ここでも同じく効果的なこのパターンを踏襲しており、次のような利点が得られます。
- 馴染みのない処理(極めて詳細なgitコマンド)の標準化
- 複雑さの回避
- 既存の特殊なクローン処理への適用しやすさ(例:gitバイナリを使わないVS Codeの「クローン」)
- バグやエッジケースの削減(各自が独自に工夫する場合と比較して)
- 実行コンテキストをまたいだ実装の一貫性(例:CIのクローン、デベロッパーのIDE、AIサンドボックス)
- 監査のしやすさの向上
- 他の自動化による設定ファイルの生成・操作
- セキュリティの向上(多くのコードインジェクション経路の排除)
インタープリターが扱えるのは設定だけです。git configのキー/値ペア、fetchとcheckoutのフラグ、スパースチェックアウトのinclude/excludeリスト、そして単純な条件で制御される少数のクローン後フックに限られます。設定に任意の項目を追加しても、エンジンはそれを認識せず無視。ポリシーが何をするのかは、ファイルを読むだけで正確に監査できます。
Git Clone Override Policyの3つの活用方法:影響の小さい順
| モード | コマンド | 管理者権限 | 適した用途 |
|---|---|---|---|
| ゼロフットプリントCLI | ./git-clone-override-policy clone URL | 不要 | CIジョブ、エージェント、単発のマシン |
| Gitエイリアス | git cloneusingpolicy URL | 不要 | 個別に導入するデベロッパー |
| OSエイリアス | git clone URL(gitバイナリの呼び出しを横取り) | 必要 | デベロッパーに意識させないフリート全体への適用 |
Git Clone Override Policyによる最適化結果の例
結果はGit Much Fasterで示したものと同じですが、今回は依頼ベースではなく自動的に得られます。
| リポジトリ | フル履歴クローン | ポリシー最適化後のクローン |
|---|---|---|
| www.gitlab.com | 9.5 GB | 110 MB |
| Linuxカーネル | 7.5 GB | 2 GB |
| Chromium | 60 GB | 5 GB |
Git LFSとの相乗効果
Git LFSとこのポリシーは、同じ問題の異なる半分を解決します。LFSはバイナリの保存方法を変え、その履歴をパックファイルから切り離すもの。一方、クローンポリシーは各クローンが何を要求するかを変えるものです。動作するレイヤーが違うため、両者は競合せずに積み重なります。LFSを使うリポジトリでも、ポリシーによるシャローなdepth、単一ブランチのrefspec、転送チューニングは、LFSが手を付けない部分を確実に削ります。さらに sparse-checkout が対象のファイル形式を名前で除外するため、現在のバイナリのsmudgeダウンロードもスキップされます。クライアント側の設定なしで、標準のgit設定変数 GIT_LFS_SKIP_SMUDGE と同じオンデマンドの挙動が得られるということです。結果は相乗的で、LFSが履歴を縮め、ポリシーがリクエストを縮める。LFSによってすでに軽量だったクローンが、さらに軽くなります。
この先の展開
このチュートリアルは、冒頭の話に立ち返って締めくくります。この問題はエージェント特有のものではありませんが、「正しい設定を周知すればよい」という前提が最も速く崩れるユースケースがエージェントです。ポリシーをコードとして扱えば、人間であれエージェントであれ、その存在を知っている必要はありません。
さらに詳しく知りたい方は、課題と解決策の適合性および設計について解説した Git Clone Override Policy Solution Architecture Overview、3つの実行モードの実際の動作を紹介する Git Clone Override Policy Demo をご覧ください。
ぜひ、ご自身の大規模リポジトリで Git Clone Override Policyをお試しください。デフォルト値の根拠となったベンチマークについては、Git Much Faster をご参照ください。
さらに検索する
すべてのブログ記事を表示する
ご意見をお寄せください
このブログ記事を楽しんでいただけましたか?ご質問やフィードバックがあればお知らせください。GitLabコミュニティフォーラムで新しいトピックを作成してあなたの声を届けましょう。
フィードバックを共有する