更新日:2026年8月25日
34分で読めます
コードが量産できる時代の新たなボトルネック
AIによってコードを生み出すコストは急速に下がっています。しかし、それを信頼するコストは下がりません。制約は「コードを書くこと」から「コードを信頼すること」へ移りつつあります。エージェント時代の新たなボトルネックと、コンテキスト・検証・ガバナンスという持続的な基盤がなぜ企業に必要なのかを考えます
1月、休暇明けに仕事へ戻った私は、何かが根本から変わったという確信を抱いていました。
大規模言語モデル(LLM)は、有用なコードを十分な信頼性で、しかも十分に安価に生み出せる水準に達していました。ソフトウェア開発の経済性そのものを変えてしまうほどに、です。世界中のエンジニアが同じことを試しているように見えました。AIアシスタントに提案を求めるだけでなく、エージェントに実際の仕事を任せ、どこまでやれるのかを見極めようとしていたのです。
これが続いたら何が起きるのか。私はそれを考え始めました。コードを生み出すことがソフトウェア構築の主たる制約でなくなったとき、次のボトルネックはどこに現れるのか。
その思考を、1月に取締役会向けのメモとして書き留めました。そして5月、論旨の一部をGitLab 第2章:エージェント型AI時代への戦略転換として公開しています。ソフトウェアを生み出すコストと時間は急速に縮小しつつあり、機械が人間の指示のもとでソフトウェアを構築する比重が高まっていく。そして、ソフトウェア開発を支えるアーキテクチャも、それに合わせて変わらざるを得ない。そうした内容です。
6月のGitLab Transcendでは、そのアーキテクチャの最初のピースをお見せしました。マシンスケールの並行処理に向けて作り直したソース管理、ソフトウェアライフサイクル全体にまたがるコンテキストグラフとしてのGitLab Orbit、そしてエージェントのアイデンティティ・ポリシー・承認・監査をめぐるガバナンスです。
そして8月21日、Anthropicが『The AI-Native SDLC Playbook』を公開しました。冒頭に置かれているのは、シンプルな一文です。
「コードはもはやボトルネックではない」
私も同意します。ただし、それは同時に次の問いを突き付けます。では、新たなボトルネックはどこにあるのか。
Anthropicのプレイブックは、エージェントが実装を劇的に加速させたときに開発ライフサイクルがどう変わるのかを、実務に即して描いています。計画は機械可読になり、引き継ぎは自動化され、検証はループの内側へ移り、人間の判断はゲートに集中していく、というものです。
私の関心は、そのワークフローのさらに一段上にあります。コードがもはや主たる制約でないとすれば、次に希少になるのは何か。人とエージェントと複数のモデルが、ソフトウェアライフサイクル全体をマシンスピードで動き回るとき、企業にはどんなアーキテクチャが必要になるのか。そして、コードを生成すること自体が潤沢になっていく世界で、持続的な価値はどこへ移るのか。
この8か月、GitLabのエンジニアリング組織、そしてStripe、Spotify、Amplitudeといった企業が、これらの問いに本番環境で答えを出し始める様子を見てきました。その経験は、私の当初の確信をより鋭いものにしてくれました。重要な変化は、AIがコードを速く生み出せるようになったこと、それ自体ではありません。
実装が劇的に安くなれば、ソフトウェアを取り巻く経済性とアーキテクチャもまた変わる。これが本質です。
制約は「コードを生み出すこと」から「コードを信頼すること」へ移ります。 そして信頼は、モデルの周囲にある環境、すなわちコンテキスト、検証、ガバナンス、エビデンスにますます依存するようになります。多数のモデルとエージェントを同時に走らせる組織にとって、この層は持続的で、かつどれか1つのモデルやエージェントから独立していなければなりません。さらに、エージェントが組織のワークフロー・専門知識・運用ノウハウをより多く内包していくのであれば、それは、その下にあるモデルやクラウドを提供するベンダーではなく、組織自身に帰属すべきものです。
産業を形づくってきた制約
この60年、ソフトウェアエンジニアリングは1つの事実を軸に組み立てられてきました。
コードは貴重である。
コードが高価なのは、ビジネス上の意図を信頼できるソフトウェアへ変換するには、複雑な抽象を頭の中に保持できる希少な人材が要るからです。壊れやすいのは、小さな誤りが甚大な結果を招きうるから。そして複雑さは、個人が吸収できる速度を超えて蓄積していきます。私たちのソフトウェアの作り方の多くは、この制約の産物でした。
古いシステムを保全するのは、作り直すことにリスクがあるから。技術を置き換えるのではなく橋渡しでつなぐのも、同じ理由です。技術的負債が何年も生き延びるのは、その返済が「今四半期に顧客が必要としているもの」と競合するからにほかなりません。
開発者の生産性を徹底して最適化してきたのも、開発者こそが希少な資源を生み出す存在だからです。断片化したツール、揃わない環境、扱いにくいプロセス。それらを変えることでエンジニアの速度が落ちるくらいなら、と黙認されてきました。
そして、儀式があります。レビュー、承認、リリースゲート、セキュリティチェック、変更管理プロセス、そして高度化を続けるテスト。その多くは、作るのに高くつき、間違えるとさらに高くつく資産を守るために存在してきました。しかも、価値の大半はそもそも形になりません。ロードマップに載る1つのアイデアの裏には、希少なエンジニアリング能力という経済性を生き延びられなかったアイデアが、はるかに多く存在します。
変更が常に高価だったからこそ、私たちは変更コストを守ることに膨大なエネルギーを注いできました。
その制約が、いま崩れ始めています。これほど根本的な制約が動けば、システムの残りの部分もいずれ動きます。
抽象化は、次の制約を露わにする
同じことは、過去にも起きています。
かつて人間は、機械語の命令で直接コンピューターを操作していました。アセンブリが機械を抽象化し、高級言語がその抽象をさらに押し上げます。どの層も、1つの問題を劇的に安くし、その背後に隠れていた問題を表に出しました。
手書きのアセンブリを惜しむ人はいません。私たちは、より大きな問題に取り組む権利を手に入れたからです。
もちろん、大規模言語モデルは技術的な意味でのコンパイラではありません。定義された意味論を持つ決定論的な変換ではなく、確率的なシステムです。それでも経済的には、このアナロジーが役に立ちます。意図から実装へ至るまでの人間の労力を、劇的に削減するという点において。
ここで効いてくる区別は、次の一点です。
コードの生産は潤沢になりつつある。だが、良いソフトウェアはそうではない。
モデルは、人間よりはるかに速く実装を生成できます。しかしそれは、その実装が正しい、安全である、性能が出る、コンプライアンスを満たす、保守できる、あるいはビジネスが意図したとおりである、という意味ではありません。このギャップこそが要点です。コードが希少だった時代、難しい問題はそれを生み出すことでした。コードが潤沢になれば、難しい問題はそれを信頼することになります。
| コードが貴重だった時代 | コードが潤沢になる時代 |
|---|---|
| 再構築は高くつくため、レガシーを保全する | 橋渡しを続けるより安くつくなら、作り直す |
| 開発者の産出量を最優先で最適化する | ビジネス成果と学習速度を最適化する |
| 技術的負債を長期にわたって抱え続ける | 採算が合う時点で負債を解消する |
| 確度の最も高いアイデアだけを追いかける | はるかに多くのアイデアを安価に試す |
| プロセスによって高コストなミスを抑える | 制約と検証によって大量の変更を統制する |
タイピングのコストが、より難しい問題を覆い隠していました。AIはそれを露わにしつつあります。
反復が安くなれば、戦略は反転する
もっともな反論の1つは、「コードを打ち込むことなど、そもそも最も難しい部分ではなかった」というものです。
より難しいのは、何を作るかを決めること。要件は曖昧で、顧客の考えは変わり、チームは互いに誤解し、重要なエッジケースはソフトウェアが現実に触れて初めて姿を現します。
いずれも、そのとおりです。
しかしその議論は、「間違えたときのコストは変わらない」という前提の上に立っています。6週間後に要件の取り違えが判明すれば、代償は大きい。だからこそ、最初に正しくあろうとする圧力が生まれます。要件定義書、アーキテクチャレビュー、入念な計画。これらはすべて、高価な反復に対する合理的な応答でした。
反復を安くすれば、戦略は反転します。
実装の前に不確実性を消し去ろうとするのをやめ、より速く学ぼうとするようになるからです。
もう1つ、さらに重要かもしれない帰結があります。エンジニアリング組織は膨大な知識を蓄積しますが、その多くはソフトウェアそのものの一部にはなりません。どのサービスが壊れやすいかを知っている、経験豊富なエンジニア。3年前のデプロイがなぜ失敗したのかを覚えている誰か。前回のインシデントを引き起こしたミスの類型を記憶しているセキュリティエンジニア。現時点では、そうした学びの多くが人の頭の中にとどまっています。実装が安くなれば、その多くを実行可能な形にできます。
本番障害は回帰テストになり、セキュリティインシデントはポリシーになる。性能要件は自動化された制約になり、コンプライアンス義務は継続的な検証になります。
学びがコードに変わるのです。
もちろん、すべてがそうなるわけではありませんし、実行可能な制約が判断を不要にするわけでもありません。ポリシーは誤りうるし、テストが昨日の前提を固定してしまうこともあるでしょう。それでも組織の知識は、学んだ本人が去れば消えてしまうものから、永続的で、検査可能で、改訂可能なものへと変わっていけます。これは別の種類の組織的記憶であり、コードの潤沢さが単に量を増やすだけでなく品質を高めうる理由の1つでもあります。
Amplitudeは最近、この種の抜本的な見直しが何をもたらすかを示す印象的な事例を公開しました。6か月で出荷したプルリクエスト数を3倍にする一方、報告された月間バグ件数は715件から319件へ減少しています。これはAI生成コードが増えれば良いソフトウェアになる、という証明ではありません。ただし、変更量が大幅に増えても品質が比例して下がるとは限らない、ということは示しています。
受け入れられた変更あたりのコスト
この移行期において最も重要だと私が考える経済単位は、コード1行あたりのコストではありません。
受け入れられた変更あたりのコストです。
有用なソフトウェア変更には、生成、環境構築、コンテキスト、検証、レビュー、修正、ガバナンスが含まれます。AIはこのうち生成の項を圧縮しつつあり、その結果として残りすべての比重が相対的に高まります。生成を10倍速くしても、CI・レビュー・検証に手を付けなければ、組織全体が10倍速くなることはありません。
待ち行列の位置が変わるだけです。
これはまさに制約理論(TOC)が予測するとおりの現象。1つのボトルネックを取り除けば、システムは次のボトルネックを露わにします。私たちはいま、それが実際に起きる場面を目にし始めています。
エージェントが本番に到達したとき、何が起きるか
Stripeはminionsと呼ばれる社内コーディングエージェントを構築しました。同社で毎週マージされるプルリクエストのうち1,000件超が、完全にminionsによって生成されたものです。レビューは人間が行いますが、コード自体はエージェント生成です。
Amplitudeは、開発パイプラインの6か月にわたる刷新を記録に残しています。プルリクエストのサイクルタイムは5.2時間から44分へ。フロントエンドのCIは約30分から3〜4分へと短縮されました。
SpotifyはHonkというバックグラウンドコーディングエージェントを運用しており、1,500件を超えるAI生成のプルリクエストが本番にマージされたことを公開しています。
いずれも並外れて能力の高いエンジニアリング組織であり、その経験を「どの企業もまもなく同じように動く」証拠として扱うべきではありません。これらが有用なのは、次の制約を露わにするところまで踏み込んでおり、しかも同じ制約がいくつも繰り返し現れているからです。
Amplitudeの開発環境には、手作業のセットアップ、遅いCI、揃わないツールが積み重なっていました。それが何年も生き延びたのは、コード生産が「変更がシステムに入ってくる速度」を律速していたからです。エージェントがその絞りを外した結果、検証とレビューが新たな停留点になりました。
そこでAmplitudeは基盤から作り直します。環境構築の高速化、CIの劇的な短縮、そして人にもエージェントにも混乱を招いていた不統一なパターンの削減。この作業のほとんどはAIではありませんでした。AIがシステムのスループットを変えたことによって必要になった、インフラの仕事です。
いま多くの組織が、最良のコーディングモデルをどれにするかに関心を集中させています。
しかし実際には、30分かかるCIパイプラインは、どんなモデルをぶつけても勝ってしまいます。
エージェントは既存のエンジニアリング上の制約をなくしてはくれません。より速く露わにするだけです。
成熟曲線ではなく、3つのモード
AI導入をめぐる説明の多くは、従来型開発から完全自律型開発へ至る単一の旅路を前提としたもの。しかし企業の移行は、そういう形では起きないと私は考えています。3つのモードが長期にわたって共存するはずです。
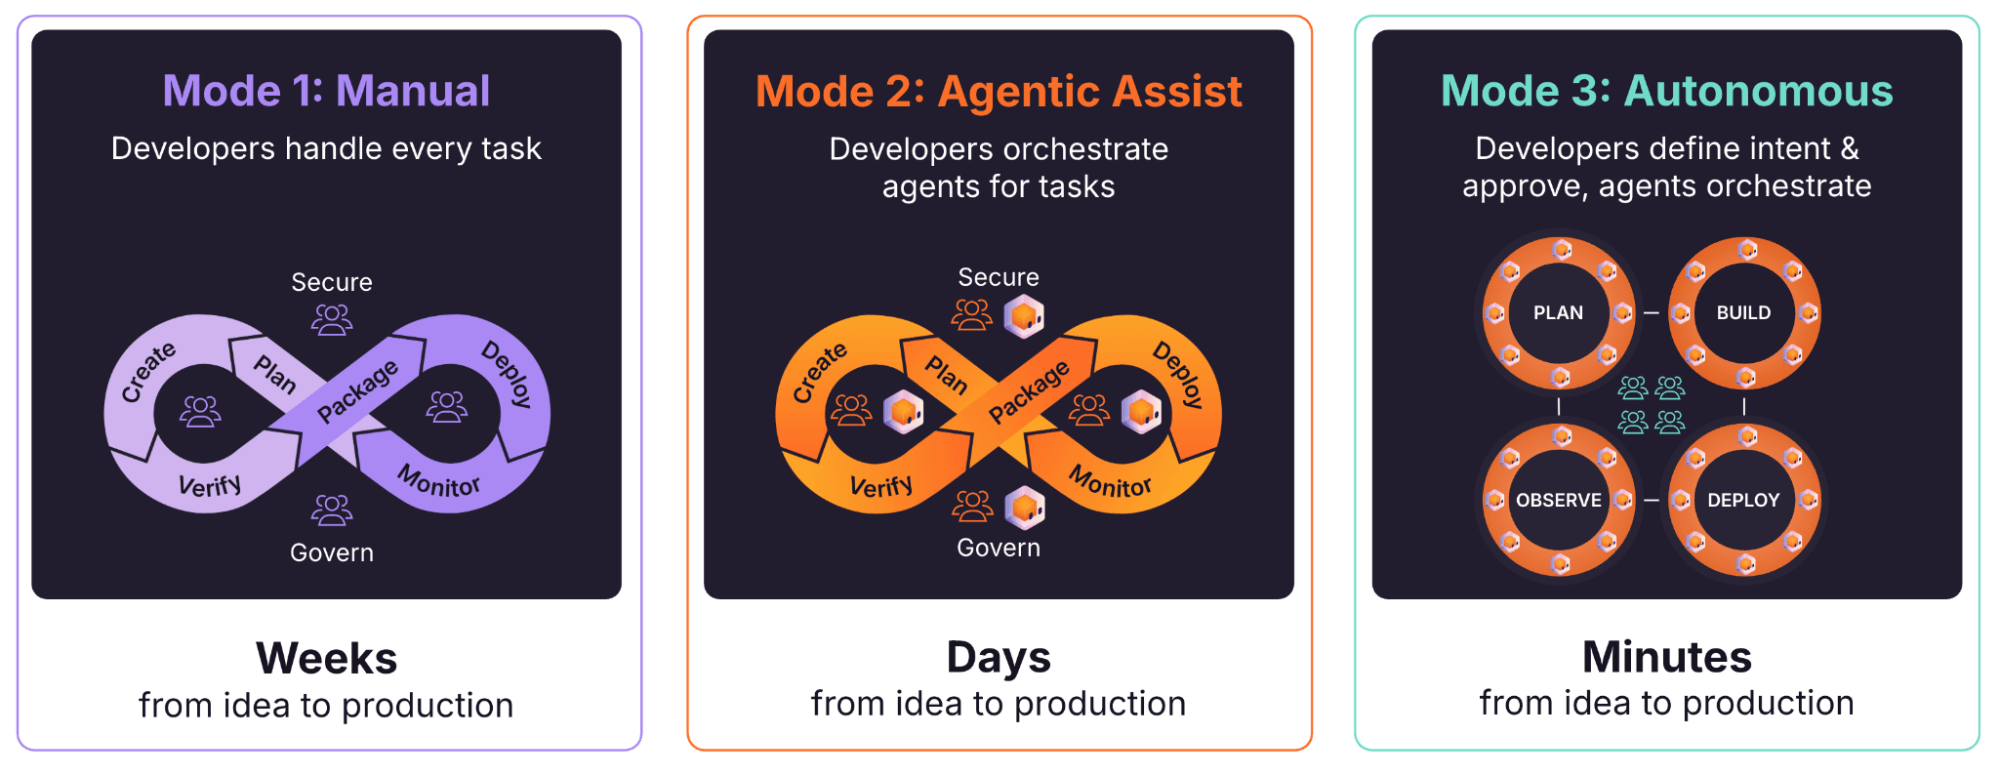
モード1:人間が制御するレガシー
依存関係が文書化されておらず、運用知識がいまだ人に宿っているシステム。その多くは、廃止されるか書き直されるまで、おおむね人間の制御下にとどまります。
モード2:エージェントによって加速された開発
人間が制御を保ちながら、エージェントが実装、テスト、移行、レビュー、ドキュメント作成、セキュリティ分析を支援します。今日の企業開発の大半がここに位置しており、近い将来の経済的価値の多くもここから生まれると見ています。
これは自律化への待合室にすぎない、というものではありません。エージェントの最も価値ある使い道の1つは、これまで採算が合わずに着手できなかったモダナイゼーション案件を、経済的に成立させることかもしれません。
モード3:自律型の開発
エージェントが実装ループを回し、人間が意図・制約・監督を与えます。重要な分かれ目はグリーンフィールドかブラウンフィールドかではありません。実行が人間の制御下にとどまるのか、それとも安全に閉じたループとして動かせるのか、です。
あるシステムがどこに位置するかを見極める実務的な方法は、3つの問いを立てることです。手元にあるコンテキストで、エージェントは有用な変更を作れるか。その変更は、人が全行を読まずに検証できるか。誤っていた場合、システムが捕捉するのか、それとも人が捕捉しなければならないのか。答えが人に依存するほど、そのワークロードはモデルの能力にかかわらずモード1寄りにとどまります。
すべてのワークロードを早々にモード3へ押し込もうとすること。それは、この移行期に組織が犯しうる最も高くつく間違いの1つになるでしょう。
パイプラインがインナーループを回す
AmplitudeがフロントエンドのCIを5分未満に短縮すると、リモートパイプラインは十分に速くなり、エンジニアは多数の作業を並行して走らせ、返ってきた結果をレビューできるようになりました。
Stripeは別の方向から同じアーキテクチャに到達しています。minionsに隔離された事前ウォームアップ済みの開発環境を与えることで、多数のジョブが互いに干渉せず並行実行できるようにしたのです。
今日のコーディングエージェントのワークフローは、いまなおノートPC上から始まるものが大半です。出発点としては妥当でしょう。ただ、アーキテクチャの終着点がそこである可能性は高くありません。
エージェント型のシステムにおいて、パイプラインは内側の開発ループ(インナーループ)を回す自然な場所になります。
生成 → ビルド → テスト → 検証 → レビュー → 修正 → 繰り返し
エージェントはこれらのシグナルに対して作業を続け、単にもっともらしいコードではなく、組織が定めた制約を満たす、機能し検証済みのソフトウェアを返せる状態に到達します。
インナーループが速くなれば、調整の必要性も高まります。個々には妥当な1,000件の変更が、システム全体を相反する方向へ引っ張ることはありうるからです。AIがSDLCの各フェーズ間の隙間を圧縮していくにつれ、意図のすり合わせは定期的なものではなく継続的なものにならざるを得ません。
このループがリポジトリとその周辺システムの近くに属すべき理由は、アーキテクチャ上にもあります。
パイプラインはすでに、コード、ビルドシステム、テストインフラ、セキュリティ制御、デプロイ設定、そして変更をめぐる履歴の多くの隣に位置しています。エージェントがそれらのシステムに近いほど、リモート呼び出しの反復や断片化したAPIを通じて再構成しなければならないコンテキストは減り、フィードバックも速く受け取れます。マシンスピードの開発では、わずかなレイテンシーやコンテキストの欠落でさえ、システム全体のボトルネックに転化しうる。これは無視できない点です。
そこでループを回すことは、作業をめぐるエビデンスの保全にもつながります。変更を開始したアイデンティティ、適用されたポリシー、実行されたテスト、行われたレビュー、エージェントが施した修正、そして最終的に出荷されたアーティファクト。これらすべてを、つながったまま保てるからです。
これは効率だけの話ではありません。自律性の拡大を統制可能にするのは、まさにこの点です。
パイプラインは、開発の最後に置かれたゲートから、開発ループそのものを回すシステムへと役割を変えていきます。
したがってエージェント型開発は、実行・コンテキスト・ガバナンスが作業の近くにある環境で最もよくスケールします。エージェントが適切なコンテキストへ速く到達し、決定論的なフィードバックを受け取り、自らの行いを証明できるほど、人に差し戻す前に安全に完了できるループの範囲は広がります。
問われているのは、もはや「コードはコンパイルできたか」ではありません。
「その変更は本当に良いものだったか、そしてそれを証明できるか」です。
自律性は与えられるものではなく、統制されるもの
モデルの能力が向上するにつれ、自律性を律速するのはガバナンスになっていくと私は考えています。
私が見てきた停滞中の企業プログラムが行き詰まる理由は、「モデルにコードを生成させられないから」であることはまずありません。
もっと基本的な問いで止まっています。このエージェントは何をしてよいのか。何をしたかをどう証明するのか。誤ったとき、誰が責任を負うのか。
Stripeのアーキテクチャは、そのパターンをよく表しています。minionsが組み合わせているのは、開放的なエージェントループと、git・Lint・テストのための決定論的なソフトウェア。隔離環境で動作し、プッシュ前にローカルのチェックを通過し、300万件を超えるテストを含むスイートから必要なものを選択的に実行します。
エージェントは創造的であってよい。
どこで創造性を止めるかを決めるのは、システムの側です。
Amplitudeはリスクモデルを用いて、自動的にマージしてよい作業と、人に回すべき作業を切り分けています。
Spotifyの検証アーキテクチャは、検証機構の実装そのものは露出させずにエージェントへ検証手段を提供し、プルリクエストを開く前に必須チェックを実行します。
これらの組織はいずれも、優れたプロンプトによって信頼性を解決したわけではありません。能力の高いモデルに、決定論的なゲート、隔離、検証、ポリシー、エビデンスを組み合わせた。それこそが、自律性を安全に広げることを可能にしています。
同時にこれは、最も恵まれたリソースを持つテクノロジー企業の外側で、なぜこれが難しくなるのかも説明しています。ほとんどの企業は、自前でエージェントの認可モデル、分離層、検証アーキテクチャ、エビデンス基盤を発明したいとは思わないでしょう。その多くは、既製のものとして受け継ぐことを期待するはずです。
GitLabでスピードとコントロールの両立と言うとき、私たちが意味しているのは、ますますこのことです。
コントロールを欠いたスピードは、組織がリスクを受け入れられなくなった時点で止まります。スピードを欠いたコントロールは、AIの価値を未実現のまま残します。この2つは、はじめから一体で設計されなければなりません。
説明責任は、むしろ明確になりうる
自律型開発に対する懸念の1つに、説明責任が機械の中へ消えてしまう、というものがあります。設計が拙ければ、確かにそうなるでしょう。しかし、アイデンティティ、ポリシー、コンテキスト、エビデンスが実行の一部として保全されるなら、自律型開発は説明責任をむしろ明示的にできます。
制約を定義する責任は、引き続き人間にあります。セキュリティポリシー、性能のしきい値、コンプライアンス義務、そして前回のインシデントから組織が学んだこと。コントロールプレーンは、それらの制約に沿って実行されたことを証明可能にしなければなりません。
AmplitudeによるSOC 2への取り組みの説明は示唆に富みます。同社の自動承認プロセスは、条件を満たすすべての変更に人が承認ボタンを押すことを求めるのではなく、文書化された基準、記録された判断、そして例外の経路に依拠しています。人の役割は、あらゆるアクションを承認することから、アクションが許可される基準そのものを所有することへ移る。これはより重みのある仕事であり、同時により監査しやすい仕事でもあります。
持続する層
エージェントの能力が高まるほど、ソフトウェアライフサイクルの多くがモデルの内側に吸収され、その周辺はコモディティ化したインフラになる。そう結論づけることもできるでしょう。 私は、むしろ逆だと考えています。
エージェントが実装ループのより多くを担うほど、企業側に持続する層の重要性は増します。コンテキスト、アイデンティティ、ポリシー、来歴、検証、組織的記憶。これらは、いまその作業を実行しているモデルやエージェントの内側だけに存在してはならないものです。それらをまたいで持続しなければなりません。
そして時間とともに、製品開発ライフサイクルは複数の専用モデルを使うようになると見ています。
タスクによって最適化すべきものは異なります。推論品質、レイテンシー、コスト、セキュリティ、ドメイン特化、あるいはモデルをどこで動かせるか。フロンティアモデルを使う場面もあれば、顧客のデータやインフラの近くに配置された小規模モデルやオープンウェイトモデルを使う場面もあるでしょう。計画に最適なモデルが、コードレビュー、セキュリティ分析、テスト、修正にも最適とは限りません。
技術が成熟するときに繰り返されてきたパターンです。単一の汎用的な能力は、ワークロードごとに最適化された、より専門的なスタックへ道を譲ります。
その世界において、モデルは持続的なアーキテクチャではありません。実行を担うコンポーネントです。
企業が使うモデルとエージェントが増えるほど、それらを取り巻く共通のコンテキスト、制御、履歴の価値は高まります。
このことは、私たちが従来ソフトウェア開発ライフサイクルと呼んできたものの境界も変えます。
SDLCは、人が一連の工程(計画、構築、テスト、セキュリティ、デプロイ、運用)を通じて作業を動かすことを前提に組み立てられてきました。AIがそれらの工程を継続的なエージェント型ループへ圧縮していくにつれ、ソフトウェアを開発することと製品そのものを開発することの区別は曖昧になっていくでしょう。
立ち上がりつつあるモデルは、**製品開発ライフサイクル(PDLC)**として捉えられます。ビジネス上の意図がシステムに入り、エージェントがそれをソフトウェアに変え、検証とガバナンスが何を先へ進めてよいかを決め、本番の結果が次の判断へ還り、ループが続いていく。そういう姿です。
十分な規模に達すると、それは従来の開発プロセスというより、ソフトウェアファクトリーに近づいていきます。意図とビジネスシグナルを、検証済みのソフトウェアへと絶えず変換し続けるシステムです。
ただし、ソフトウェアファクトリーは自律型エージェントの寄せ集めではありません。その下で、モデルとエージェントが入れ替わってもコンテキスト、アイデンティティ、ポリシー、エビデンス、組織的記憶を保ち続けるもの。それが、持続する層です。
コンテキストと来歴
AnthropicのAIネイティブSDLCプレイブックが有用なのは、この移行を具体的なものにしているからです。意図、仕様、計画が機械可読なアーティファクトになること。組織的知識がClaudeから利用可能になること。フックとスキルが振る舞いを強制すること。MCPがエージェントとツールをつなぐこと。そしてバージョン履歴が作業のエビデンスを保全すること。いずれも有用なパターンであり、多くの組織はここから始めるはずです。
GitLabのアーキテクチャ上の賭けは、エージェント型開発には優れたモデルだけでなく、新しいプラットフォームアーキテクチャが必要だ、というものです。
そのアーキテクチャに不可欠な能力は4つ。エージェントプラットフォーム、マシンスケールの実行、持続的なコンテキスト、そしてガバナンスです。それぞれについては後ほど改めて触れます。
企業が使うモデルは1つではありません。複数ベンダーのエージェントと、自社で構築したエージェントを併用するようになります。そしてますます、ベンダーが優れたエージェントを出し続ける一方で、自社のワークフロー・専門知識・運用ポリシーを内包したエージェントを自ら作りたいと考えるようになるでしょう。
だからこそプラットフォームは、両方の道を支える必要があります。顧客が選んだエージェントを持ち込めること。そして自社が所有するエージェントを構築し、カスタマイズし、運用できること。
それらのエージェントは、コード、計画、セキュリティ、CI、デプロイ、本番システムをまたいで、しばしば同時に動きます。組織が好みのモデルやクラウドを変えたからといって、作り直しを迫られるべきではありません。そして組織のコンテキスト、ポリシー、アイデンティティ、履歴が、その時々で優勢なモデル・エージェントベンダー・インフラ事業者に囚われてしまうべきでもありません。
モデルは交換可能に。エージェントは顧客のものに。そして組織の記憶と制御は、そのすべてを超えて残るべきです。
アーキテクチャ上の圧力が向かう先は、単一のモデル・エージェントベンダー・クラウドがシステムオブレコードになることではなく、モデル中立・クラウド中立のプラットフォームである。私がそう考える理由がここにあります。
これは、1社のベンダーがソフトウェア開発に関わるあらゆるアーティファクトを所有しなければならない、という意味ではありません。アイデンティティは連携可能。イベントはシステム間を移動できます。インデックス化できるコンテキスト、集中管理できるポリシー。MCPをはじめとするオープンなインターフェースは、企業全体のツールへエージェントがアクセスする手段を与えてくれます。多くの組織はこの形で構築していくでしょう。
このパターンにおいて難しいのは、自律的なシステムがその環境をまたいで動作するなかで、意図から行動、そして結果に至る鎖をどう保つかという点です。
ある要求が変更を認可する。変更は特定のアイデンティティとポリシー体系のもとで実行される。検証がエビデンスを生む。デプロイがそれを出荷する。本番が結果を生む。これらの関係は、1つの因果グラフを形づくります。
新しい話ではありません。変わりつつあるのは、その関係が壊れずに保たれていなければならない頻度です。人間の開発速度であれば、複数システムにまたがる来歴を事後に再構成するのは、骨は折れても多くの場合は成立しました。
マシンスピードでは、来歴は実行経路そのものの一部になります。
関連する関係が共通のシステムやコントロールプレーンにネイティブに存在していれば、エージェントはそれらを直接たどって推論できます。複数のシステムに分散していれば、何かがそれを再構成しなければなりません。それは可能ではあります。ただし、アイデンティティ、同期、ポリシーの一貫性、セマンティックマッピング、エビデンスをめぐる作業が発生します。マシンスケールの分量になれば、この突き合わせ作業自体がシステムの制約になりかねません。
Spotifyの経験は、同じ問題がコードベースの内側で起きることを示しています。ある移行案件で、Honkは複数のパイプラインフレームワークに遭遇しました。標準化が進んだフレームワークほど自動化しやすく、不統一は信頼できるコンテキストの構築をはるかに難しくしました。人間の速度なら、不統一なコンテキストは摩擦を生む程度で済みます。マシンスピードでは、出力の品質を繰り返し劣化させます。
自律型開発において重要な単位は、個々のアーティファクトではなくなりつつあります。意図、コード、ポリシー、エビデンス、デプロイ、成果のあいだの関係こそが重要です。
ソフトウェア開発のインナーループが、共通のコントロールプレーンへ向かう圧力を強めていくと私が考える理由はここにあります。1社のベンダーがすべてのツールを所有しなければならないからではありません。信頼できる自律性には、人間が経験したことのない規模で機械が動くあいだも、それらの関係が整合したまま保たれることが必要だからです。すでに多くの関係を保持しているプラットフォームは、事後に再構成しなければならないシステムに対して構造的な優位を持ちます。
ファイルではなく、レコードとして
エージェント型開発で広がりつつある実践の1つに、意図・仕様・実装計画をMarkdownファイルとしてリポジトリにコミットする、というものがあります。
この直感は良いと思います。意図を明示的にし、バージョン管理し、人にもエージェントにも読める形にすることは、すぐに価値を生みます。
ただし、ファイルと、統制可能なレコードのあいだには重要な違いがあります。企業規模になると、システムはいずれ、ファイル単体では答えられない問いに答える必要が出てきます。
- 誰がこれを変更できるのか
- いまどの状態にあるのか
- 誰が承認したのか
- どのバージョンのポリシーが適用されたのか
- これによってどのデプロイが行われたのか
- 1万件のこれらを横断的に検索するには、どうすればよいのか
Markdownをめぐる取り決めによってこれらの能力を再現することもできますが、それこそシステムオブレコードが何年もかけて磨いてきた能力そのものです。
最良のアーキテクチャは、エージェントに対してはMarkdownをインターフェースとして提示しつつ、その下には構造化され統制されたレコードを保つ形かもしれません。
インターフェースは単純なままでよい。その下のシステムは、そうはいきません。
エージェントは組織に帰属すべきである
エージェントには、組織がどのようにソフトウェアを作っているかについてのコンテキストが必要です。リポジトリ構造、コーディング規約、ビルドコマンド、テストの慣行、アーキテクチャ上のルール、既知の障害モード。
Spotifyはこの取り組みをコンテキストエンジニアリングと呼び、実際のコードベースでマージ可能で信頼できるプルリクエストを生み出すうえで不可欠だと結論づけています。この知識が積み上がるほど、それは組織の資産になっていきます。
同じことが、エージェント自体についても言えるようになってきました。
企業のエージェントは、長年にわたって蓄積された指示、ワークフロー、ツールアクセス、評価基準、運用ポリシーを内包しうるものです。時間が経てば、それはエンジニアリング組織で最も価値ある知的財産の1つになりえます。
それはモデルベンダーやクラウド事業者、あるいはプロプライエタリなランタイムではなく、組織に帰属すべきものです。
所有が重要である理由は、もう1つあります。所有によって、システムが複利で効いてくるからです。
エージェントが動くたびに、組織は何がうまくいき何がうまくいかなかったかについてのエビデンスを生み出します。どの変更が受け入れられたか。どれが却下されたか。人はどこで介入したか。本番では何が失敗したか。どの制約が問題を捕捉したか。
これらを長期にわたって保全すれば、公開ベンチマークではなく、自社のコードベースと自社の成果に根ざした内部の評価セットになります。組織はそれを使ってモデルを評価し、エージェントを改善し、指示やワークフローを洗練させ、どこで自律性を高めるのが実際に妥当なのかを判断できます。
こうして生まれるのがフィードバックループです。エージェントが作業し、システムが成果を測り、そこから組織が学んだことが、次世代のエージェントをその組織の仕事によりよく適合させていきます。
これは「学びがコードに変わる」という考えの延長線上にあります。学びはテストやポリシーになりうるだけでなく、評価セット、コンテキスト、そして改善されたエージェントにもなりうるのです。
特定のベンダーを否定する議論ではありません。GitLabは今日Anthropicのモデルの上に構築しており、今後もそうし続けるつもりです。Claude Codeを使っている顧客は、それを使い続けられるべきであり、私たち自身が作るエージェントと同じ企業コンテキスト、アイデンティティ、監査証跡を伴っているべきです。
要点はこうです。顧客はモデルを選び、変更し、タスクごとに異なるモデルを使い、自社のビジネスが求めるインフラ上でエージェントを動かせなければなりません。加えて、他ベンダーのエージェントを持ち込み、同じ企業コンテキストと制御を与えられるべきです。
AGENTS.mdは、コーディングエージェントにプロジェクトの指示とコンテキストを与えるオープンフォーマットの一例。GitLabはこれをサポートしており、今後も同種のオープンフォーマットを支持していきます。組織が積み上げた知識は、モデルやエージェント、ベンダーを変えても持ち運べるものであるべきだからです。
ファイル名より、原則のほうが重要です。
エージェントを所有する。その指示を所有する。それが学ぶコンテキストを所有する。その下のモデルとインフラは、選択可能なままにしておく。
誰もが出荷できる
Amplitudeの経験で興味深い結果の1つは、エンジニアに関するものではありませんでした。開発環境、検証、レビューを改善した後、デザイナー、プロダクトマネージャー、マーケターが自らコード変更を生み出し始めたのです。非エンジニアによるプルリクエストは、ほぼゼロから約5%まで増えました。
これは、今後はるかに大きくなると私が見ている変化の、初期形。実装が安くなるにつれ、「何を作るかを決めること」と「作ること」の境界は崩れ始めます。プロダクトマネージャーは意図を動くソフトウェアに変えられます。プロトタイプから実装へ踏み出すデザイナー。製品全体をより高い抽象度で扱えるようになるエンジニア。そして従来のR&D組織の外側にいる人々も、すでに持っている専門性から直接ソリューションを作れるようになっていきます。
この広がった役割を表す言葉として、**ビルダー(Builder)**が有用になると考えています。ビルダーはエンジニアかもしれないし、デザイナー、プロダクトマネージャー、セキュリティ専門家、マーケター、あるいはドメインエキスパートかもしれません。共通するのは、意図を表現し、エージェントに方向を与え、結果を評価し、アイデアを動くものに変える力です。
これは先に述べたPDLCへの移行の一部でもあります。製品の意図、デザイン、実装、フィードバックのあいだの距離が縮まるにつれ、ソフトウェア開発はエンジニアリング内部の専門的な引き継ぎというより、継続的な製品づくりのループに近づいていきます。
専門性が消えるとか、誰もがエンジニアになる、という意味ではありません。むしろ逆かもしれません。エージェントが実装作業を吸収するほど、ドメインの専門性と判断力の価値は高まります。エージェント型システムを監督するのは、コーディングエージェントを管理するエンジニアリングマネージャーではなく、何が起こるべきかを表現でき、その結果が正しいかを見抜けるドメインエキスパートかもしれません。
結果として、ソフトウェアを作れる人の母数は大きく広がります。ただし、エンジニアリング上の判断力が潤沢になるわけではありません。
希少な人間の注意は、上流へ移動します。意図、アーキテクチャ、制約、難しいトレードオフ、例外、そしてシステムが組織の望んだ成果を実際に生んだかどうかの評価へ。
ソフトウェアを作る仕事はエンジニアリングの外へ広がります。判断の必要性は、広がりません。
統合は外側へ移る
以上は、統合が重要でなくなるという意味ではありません。その重心が移る、ということです。
高頻度の実行ループの内側では、より密な統合の価値が高まります。エージェントは速いフィードバック、一貫したアイデンティティ、共有されたコンテキスト、実効性のあるポリシーに依存するからです。
そのループの外側では、統合の重要性はさらに増します。ソフトウェアを動かす意図が、ビジネスの他の場所から生まれてくる度合いが高まるためです。
カスタマーサポートにあるのは、顧客の痛み。CRMには約束が、データプラットフォームには利用状況とビジネス成果が、可観測性には本番の健全性が、コンプライアンスシステムには義務が記述されています。これらのシステムはシグナル、意図、制約を提供し、開発のコントロールプレーンがそれらを統制された行動へ変換します。
時間とともに、ビジネスシグナルとソフトウェアによる応答のあいだの距離は、劇的に縮まっていくと見ています。
その世界で最も重要な開発プラットフォームは、いくつの開発者向けツールを置き換えられるかよりも、統制されたソフトウェア実行を「ビジネスが何を必要としているかを記述するシステム」にどれだけ効果的につなげられるかによって定義されるのかもしれません。
新しいプラットフォームアーキテクチャ
その未来には、4つの能力を軸としたプラットフォームアーキテクチャが必要になります。
エージェントプラットフォーム: 組織が所有するエージェントを、自ら選んだモデルとインフラを用いて作成・カスタマイズ・運用できること。同時に、顧客が他所から持ち込むエージェントも支えられること。
実行: 次世代のGit、アーティファクト管理、CI/CD、そして人間とマシンの双方のスケールでソフトウェアをビルド・テスト・デプロイ・運用できる能力。
コンテキスト: 作業を取り巻く要求、コード、履歴、ビジネス上の優先順位、制約についての、一貫した全体像。
ガバナンス: セキュリティ、コンプライアンス、品質、アイデンティティ、権限をめぐる実効性のある境界。加えて、エージェントが何を行い、なぜそれが許されたのか、どこで人の注意が必要なのかを人が理解するための可視性。
自律性が高まるにつれ、ガバナンスはすべての行動を承認することよりも、例外を人が理解し舵取りできるようにすることへ比重を移していきます。ポリシーとテストは、組織がすでに下した判断を自動化するもの。より難しいのは、誰も想定していなかったケースです。
自律性の最終的な制約は、エージェントが行動できるかどうかではないかもしれません。数百のエージェントが同時に何をしているのかを、人が理解し舵取りできるかどうかです。
これら4つのアーキテクチャ層は、互いを強化し合います。エージェントは実行層を通じて行動し、実行はコンテキストを豊かにするシグナルを生みます。コンテキストが良くなればエージェントの能力は高まり、ガバナンスはより精緻になる。ガバナンスが強くなれば、エージェントはより高い自律性で動けるようになります。
企業には、これらの能力が一貫したプラットフォームとして機能することが求められます。その下で、多様なモデル、クラウド、製品、エージェントが参加していてもなお、です。
これが実務上、何を意味するか
これらは、遠い自律化の未来に向けたアーキテクチャ原則にとどまりません。すでに、私たちが作るものを変えています。
GitLab 第2章では、ソフトウェア開発がマシンスケールで動くようになるという前提に基づき、いくつかのアーキテクチャ上の賭けを示しました。6月のGitLab Transcendでは、そのアーキテクチャの最初のピースを、それぞれのデモとともにお見せしています。
顧客には、自ら所有するエージェントを構築し運用する場が必要です。 GitLab Duo Agent Platformは、組織自身のワークフローと専門知識に沿ってエージェントを作成・カスタマイズ・運用するための私たちのプラットフォームであり、その下で使うモデルは顧客が選べ、ビジネスが要求するインフラ上で動かせます。外部のエージェントとの併用も可能。目的は、すべての企業を1つのエージェントエコシステムに押し込むことではありません。単一のモデルやクラウドに縛られることなく、自ら所有し進化させられるエージェントの置き場所を提供することです。
実行はマシンスケールで動かなければなりません。 エージェントは、従来のソース管理アーキテクチャが想定していなかった量でクローン、ブランチ作成、リトライ、パイプライン起動を行います。この現実に合わせて作り直しを進めているのが、私たちの次世代ソース管理。リポジトリ全体を繰り返し移動させるのではなく、タスクが実際に必要とするものだけをエージェントが取得できるサーバーサイドのアクセスパターンも含まれます。社内テストでは、これらの変更によってタスク実行が最大50倍高速になり、移動するデータ量は劇的に減少しました。
コンテキストはインフラにならなければなりません。 コード、作業アイテム、パイプライン、デプロイ、本番のシグナル。GitLab Orbitは、これらをソフトウェアライフサイクル全体にまたがるコンテキストグラフとして結び付けます。エージェントは、切り離された数十回の呼び出しを通じて関係を再構成する代わりに、直接クエリできます。重要なのは、このコンテキストがGitLab自身のエージェント専用ではないという点。サードパーティのエージェントも、同じ組織的記憶を利用できます。
ガバナンスはプロンプトの内側ではなく、エージェントの外側を囲むべきものです。 Governance for Agentsは、エージェントの行動にアイデンティティ、ポリシー、承認、監査の制御を適用する設計。エビデンスと説明責任を手放すことなく、組織が自律性を高められるようにするためです。
いずれも別々のエンジニアリングプロジェクトですが、出発点にある前提は同じです。
実装が潤沢になっていくのなら、その下のプラットフォームは、企業がエージェントを構築し、また持ち込めるようにしたうえで、そのすべてにマシンスケールの実行、コンテキスト、制御を与えなければならない。
今後90日で取り組むべきこと
受け入れられた変更あたりのコストを測る。 生成された変更が受け入れられるまでの所要時間を追跡し、環境、CI、レビュー、修正、ガバナンスへ分解してください。多くのチームは、生成がすでに全体のごく一部にすぎないことに気づくはずです。
CIの時間を計る。 フルパイプラインに5分より大幅に長くかかっているなら、モデルを乗り換えるより、そこを改善するほうが効くかもしれません。
承認だけでなく、基準を書き出す。 低リスクな変更を1種類選び、人を介さずにマージしても安全だと言える条件を定義してみてください。それが、実行可能なガバナンスの出発点になります。
コンテキストを持ち運べるようにする。 リポジトリの指示や運用ノウハウを、人とエージェントの双方が使えるオープンでバージョン管理された形式に置いてください。
どのビジネスシグナルを開発ループへ直接入れるかを決める。 サポート、可観測性、コンプライアンスのシステムには、意図と制約が蓄積されつつあります。人が転記しなくても統制されたソフトウェア作業になるべきシグナルはどれか。それを決めてください。
ここからどこへ向かうのか
コード生成はコモディティ化しつつあります。それはソフトウェア開発が無料になるという意味ではありません。経済性が変わり、ボトルネックの位置が変わるという意味です。
有用な単位は、コード1行あたりのコストではありません。
受け入れられた変更あたりのコストです。
生成が安くなるほど、その周囲にあるすべての比重が相対的に高まります。環境、コンテキスト、検証、ガバナンス、エビデンスです。
これは、希少な人間の判断がどこへ向かうのかも変えます。実装が潤沢になったからといって、エンジニアリングの判断力まで潤沢になるわけではありません。人間の注意は上流へ移ります。アーキテクチャ、意図、制約、難しい例外、そしてシステムが組織の望んだ成果を生んだかどうかの評価へ。
そして、ソフトウェア開発スタックのどこに戦略的価値が蓄積されるのか、についての私の見方も変わります。この60年、実装は十分に希少であり、ソフトウェアエンジニアリングの多くは開発者の能力を守り、変更コストを抑えることを軸に回ってきました。AIはその制約を変えます。
実装が潤沢になれば、信頼が希少になります。
信頼には、モデルがもっともらしい答えを返す以上のものが要ります。そのソフトウェアが正しい制約のもとで作られ、組織の意図どおりに振る舞ったというエビデンスが必要です。企業はこれらの能力を複数の製品から組み上げることもできますし、実際に多くはそうするでしょう。ただしマシンの活動量が増えるほど、断片化したコントロールプレーンは、ますます高くつく突き合わせ問題を生み出します。
したがってアーキテクチャ上の圧力が向かう先は、1社のベンダーがすべてを所有することとは限りません。
向かう先は、企業が自ら選んだエージェントを持ち込み、自ら所有するエージェントを構築・カスタマイズし、そのすべてに実行・コンテキスト・ガバナンスという共通の層を与えられる、モデル中立・クラウド中立のプラットフォームです。
そこに、GitLabにとっての機会があると私たちは見ています。
モデルは変わるかもしれません。クラウドも変わるかもしれません。エージェントはベンダー製かもしれないし、顧客が作ったものかもしれません。
組織の知性、コンテキスト、制御は、そのすべてを超えて生き残らなければなりません。
Stripe、Spotify、Amplitudeは、卓越したエンジニアリング組織が自力で何を作れるかを示しました。Anthropicのプレイブックは、ソフトウェア開発を取り巻く運用モデルがどれほど速く変わり始めているかを示しています。ほとんどの企業には、その仕組み一式をゼロから再現できるプラットフォームチームがいません。多くを受け継ぐ必要があるでしょう。
ソフトウェアエンジニアリングは、60年を希少な資源の保護に費やしてきました。次の10年は、潤沢な資源の統制に費やすことになります。
そちらのほうが、良い問題です。
出典
- GitLab『GitLab 第2章:エージェント型AI時代への戦略転換』2026年5月11日 about.gitlab.com/ja-jp/blog/gitlab-act-2
- GitLab『GitLab:エージェント型エンジニアリング時代のプラットフォーム』2026年6月10日、GitLab Transcendのデモ動画付き about.gitlab.com/ja-jp/blog/gitlab-transcend-announcements
- Anthropic『The AI-Native SDLC Playbook』2026年8月21日 claude.com/blog/the-ai-native-sdlc-playbook
- Amplitude EPD『Speedrunning Software: How We 3×'d PRs in 6 Months』 amplitude.com/3x
- Stripe『Minions: Stripe's one-shot, end-to-end coding agents』 パート1、パート2
- Spotify Engineering『Background Coding Agents』 パート1、パート2、パート3、パート4
AGENTS.md(コーディングエージェントに指示を与えるためのオープンフォーマット)- ゴールドラット『制約理論(TOC)』 tocinstitute.org
さらに検索する
すべてのブログ記事を表示する

ご意見をお寄せください
このブログ記事を楽しんでいただけましたか?ご質問やフィードバックがあればお知らせください。GitLabコミュニティフォーラムで新しいトピックを作成してあなたの声を届けましょう。
フィードバックを共有する