Veröffentlicht am: 24. August 2026
31 Minuten Lesezeit
Wenn Code im Überfluss vorhanden ist
Code zu erzeugen wird billig. Ihm zu vertrauen nicht. Warum Unternehmen eine dauerhafte Schicht aus Kontext, Verifikation und Governance brauchen.
Aus der Weihnachtspause kam ich im Januar mit der Überzeugung zurück, dass sich etwas Grundlegendes verändert hatte.
Große Sprachmodelle waren an dem Punkt angelangt, an dem sie brauchbaren Code zuverlässig genug und günstig genug erzeugten, um die Ökonomie der Softwareentwicklung zu verändern. Überall schienen Entwicklungsteams dasselbe auszuprobieren: nicht mehr nur eine KI-Assistenz um Vorschläge zu bitten, sondern Agenten echte Arbeit zu geben und zu sehen, wie weit sie damit kommen.
Ich begann darüber nachzudenken, was geschieht, wenn das so weitergeht. Was ändert sich, wenn das Erzeugen von Code nicht mehr der zentrale Engpass beim Bau von Software ist?
Diese Gedanken habe ich im Januar in einem Memo an den Vorstand festgehalten. Im Mai habe ich einen Teil dieser These in GitLabs Act 2 veröffentlicht: Kosten und Zeit für die Herstellung von Software brechen ein, Maschinen werden Software zunehmend unter menschlicher Anleitung bauen, und die Architektur unter der Softwareentwicklung muss sich mit verändern.
Im Juni haben wir auf GitLab Transcend die ersten Teile dieser Architektur gezeigt: eine für maschinelle Nebenläufigkeit neu gebaute Versionsverwaltung, GitLab Orbit als Kontextgraph über den gesamten Software-Lebenszyklus und Governance rund um Agentenidentität, Richtlinien, Freigaben und Audit.
Am 21. August hat Anthropic dann The AI-Native SDLC Playbook veröffentlicht. Es beginnt mit einem einfachen Satz:
"Code ist nicht länger der Engpass."
Dem stimme ich zu.
Anthropics Playbook beschreibt praxisnah, wie sich der Entwicklungszyklus verändert, sobald Agenten die Umsetzung drastisch beschleunigen: Planung wird maschinenlesbar, Übergaben laufen automatisch, Verifikation rückt in die Schleife hinein, und menschliches Urteil sammelt sich an den Toren.
Mich interessiert, was eine Ebene darüber geschieht. Wenn Code nicht mehr der zentrale Engpass ist, was wird dann knapp? Welche Architektur braucht ein Unternehmen, wenn Menschen, Agenten und mehrere Modelle gleichzeitig und in Maschinengeschwindigkeit über den Software-Lebenszyklus hinweg handeln? Und wohin wandert dauerhafter Wert, wenn das Erzeugen des Codes selbst immer reichlicher verfügbar wird?
In den vergangenen acht Monaten habe ich beobachtet, wie GitLabs Engineering und andere Organisationen, darunter Stripe, Spotify und Amplitude, diese Fragen im Produktivbetrieb zu beantworten beginnen. Ihre Erfahrungen haben meine ursprüngliche Überzeugung geschärft. Die wichtige Veränderung besteht nicht einfach darin, dass KI Code schneller erzeugen kann.
Sie besteht darin, dass sich mit drastisch billigerer Umsetzung auch Ökonomie und Architektur rund um Software verändern.
Der Engpass verschiebt sich vom Erzeugen des Codes zum Vertrauen in ihn. Vertrauen hängt zunehmend von der Umgebung um das Modell herum ab: Kontext, Verifikation, Governance und Belege. Wenn Organisationen viele Modelle und Agenten gleichzeitig betreiben, muss diese Schicht dauerhaft und von jedem einzelnen davon unabhängig sein. Und je mehr Agenten die Arbeitsabläufe, das Fachwissen und das Betriebswissen einer Organisation in sich aufnehmen, desto mehr sollten sie der Organisation gehören und nicht demjenigen Anbieter, der das Modell oder die Cloud darunter liefert.
Wie ein Engpass eine Industrie formte
Sechzig Jahre lang hat sich Software-Engineering um eine Tatsache herum organisiert:
Code ist kostbar.
Er ist teuer, weil die Übersetzung geschäftlicher Absicht in verlässliche Software nach gut ausgebildeten Menschen verlangt, die komplexe Abstraktionen im Kopf behalten können. Er ist zerbrechlich, weil kleine Fehler enorme Folgen haben können. Und Komplexität wächst schneller, als sie ein Einzelner aufnehmen kann. Vieles daran, wie wir Software bauen, stammt aus diesem Engpass.
Wir bewahren alte Systeme, weil ein Neubau riskant ist. Wir bauen Brücken zwischen Technologien, statt sie zu ersetzen. Technische Schulden überdauern Jahre, weil ihr Abbau mit dem konkurriert, was die Kundschaft in diesem Quartal braucht.
Wir richten vieles auf die Produktivität der Entwicklungsteams aus, weil sie die knappe Ressource herstellen. Zersplitterte Werkzeuge, uneinheitliche Umgebungen und unbequeme Prozesse werden hingenommen, wenn eine Änderung daran die Entwicklung bremsen könnte.
Dazu kommt die Zeremonie: Reviews, Freigaben, Release-Gates, Sicherheitsprüfungen, Änderungsprozesse und immer ausgefeiltere Tests. Vieles davon existiert, um ein Gut zu schützen, dessen Herstellung teuer ist und dessen Fehler teuer sind. Und der größte Teil des Werts entsteht überhaupt nie. Auf jede Idee, die es auf eine Roadmap schafft, kommen viele weitere, welche die Ökonomie knapper Entwicklungskapazität nicht überleben.
Wir stecken enorme Energie in den Schutz vor Änderungskosten, weil Änderungen immer teuer waren.
Dieser Engpass beginnt zu brechen. Und wenn ein derart grundlegender Engpass sich verschiebt, verschiebt sich irgendwann alles Übrige mit.
Jede Abstraktion legt den nächsten Engpass frei
Das ist schon einmal geschehen.
Menschen haben Computer einst unmittelbar in Maschinenbefehlen programmiert. Assembler hat die Maschine abstrahiert. Höhere Programmiersprachen haben die Abstraktion erneut verschoben. Jede Schicht hat ein Problem drastisch verbilligt und dabei das dahinterliegende freigelegt.
Handgeschriebenem Assembler trauert niemand nach. Wir haben ein größeres Problem bekommen, an dem wir arbeiten können.
Große Sprachmodelle sind im technischen Sinn offensichtlich keine Compiler. Sie sind probabilistische Systeme, keine deterministischen Übersetzungen mit definierter Semantik. Ökonomisch aber taugt der Vergleich: Sie verringern den menschlichen Aufwand drastisch, der vom Vorhaben zur Umsetzung führt.
Entscheidend ist dieser Unterschied:
Die Erzeugung von Code wird einfach. Gute Software nicht.
Modelle können Umsetzung weit schneller erzeugen, als Menschen es können. Das heißt nicht, dass sie korrekt, sicher, performant, regelkonform, wartbar oder auch nur das ist, was fachlich gemeint war. Genau diese Lücke ist der Punkt. Als Code knapp war, bestand das schwierige Problem darin, ihn herzustellen. Wird Code reichlich, besteht das schwierige Problem darin, ihm zu vertrauen.
| Wenn Code kostbar ist | Wenn Code im Überfluss vorhanden ist |
|---|---|
| Altsysteme bewahren, weil ein Neubau teuer ist | Neu bauen, sobald das günstiger ist als weiter zu überbrücken |
| Vor allem auf den Ausstoß der Entwicklung hin optimieren | Auf geschäftliche Ergebnisse und Lerngeschwindigkeit hin optimieren |
| Technische Schulden lange mitschleppen | Schulden abbauen, sobald die Ökonomie dafür spricht |
| Nur die aussichtsreichsten Ideen verfolgen | Viel mehr Ideen günstig erproben |
| Mit Prozess teure Fehler begrenzen | Mit Leitplanken und Verifikation viele Änderungen steuern |
Die Kosten des Code-Tippens haben die schwereren Probleme verdeckt. KI legt sie offen.
Billige Iteration verändert die Strategie
Ein berechtigter Einwand lautet, das Tippen von Code sei nie der schwierigste Teil gewesen.
Schwieriger ist die Entscheidung darüber, was gebaut werden soll. Anforderungen sind mehrdeutig. Die Kundschaft ändert ihre Meinung. Teams verstehen einander falsch. Wichtige Sonderfälle zeigen sich erst, wenn Software auf die Wirklichkeit trifft.
Alles zutreffend.
Dieser Einwand setzt aber voraus, dass die Kosten des Irrtums gleich bleiben. Nach sechs Wochen festzustellen, dass eine Anforderung missverstanden wurde, ist teuer. Diese Kosten erzeugen den Druck, von vornherein richtig zu liegen. Anforderungsdokumente, Architektur-Reviews und sorgfältige Planung sind vernünftige Antworten auf teure Iteration.
Wird Iteration billig, kehrt sich die Strategie um.
Man versucht dann nicht länger, Unsicherheit vor der Umsetzung zu beseitigen, sondern schneller zu lernen.
Es gibt eine weitere Folge, die sich als noch wichtiger erweisen könnte. Entwicklungsorganisationen sammeln enorme Mengen an Wissen an, das nie Teil der Software selbst wird. Eine erfahrene Person weiß, welcher Dienst fragil ist. Jemand erinnert sich, warum vor drei Jahren ein Deployment scheiterte. Aus der Security erinnert sich jemand an die Fehlerklasse, die den letzten Vorfall verursacht hat. Heute liegt viel davon in menschlichen Köpfen. Wird Umsetzung billig, kann mehr davon ausführbar werden.
Aus einem Produktionsausfall wird ein Regressionstest. Aus einem Sicherheitsvorfall wird eine Richtlinie. Aus einer Performance-Anforderung wird eine automatisch geprüfte Leitplanke. Aus einer Compliance-Pflicht wird fortlaufende Validierung.
Aus Gelerntem wird Code.
Nicht buchstäblich alles davon, und ausführbare Leitplanken ersetzen kein Urteilsvermögen. Richtlinien können falsch sein. Tests können die Annahmen von gestern festschreiben. Aber organisationales Wissen kann zunehmend dauerhaft, einsehbar und überarbeitbar werden, statt zu verschwinden, sobald die Person geht, die es erworben hat. Das ist eine andere Art institutionellen Gedächtnisses, und es ist ein Grund, warum reichlich vorhandener Code die Qualität verbessern kann, statt nur das Volumen zu erhöhen.
Amplitude hat vor Kurzem ein bemerkenswertes Beispiel dafür veröffentlicht, was ein grundlegender Umbau dieser Art bewirken kann. In sechs Monaten hat das Unternehmen die Zahl der ausgelieferten Pull Requests verdreifacht, während die gemeldeten monatlichen Fehler von 715 auf 319 fielen. Das beweist nicht, dass mehr KI-erzeugter Code bessere Software ergibt. Es zeigt aber, dass ein deutlich höheres Änderungsvolumen nicht zwangsläufig entsprechend niedrigere Qualität bedeutet.
Kosten pro akzeptierter Änderung
Die ökonomische Einheit, auf die es in diesem Übergang meiner Ansicht nach am meisten ankommt, sind nicht die Kosten pro Codezeile.
Es sind die Kosten pro akzeptierter Änderung (cost per accepted change).
Zu einer brauchbaren Softwareänderung gehören Erzeugung, Einrichtung der Umgebung, Kontext, Verifikation, Review, Nachbesserung und Governance. KI lässt den Erzeugungsanteil zusammenschrumpfen, wodurch alles Übrige anteilig wichtiger wird. Eine Organisation, welche die Erzeugung verzehnfacht, CI, Review und Validierung aber unangetastet lässt, wird nicht zehnmal schneller.
Sie verschiebt lediglich die Warteschlange.
Genau das sagt die Theory of Constraints voraus: Wird ein Engpass beseitigt, legt das System den nächsten frei. Das beginnt gerade sichtbar zu werden.
Agenten im Produktivbetrieb
Stripe hat interne Coding-Agenten namens Minions gebaut. Von den Pull Requests, die bei Stripe wöchentlich gemergt werden, stammen mehr als tausend vollständig von Minions. Menschen prüfen sie, der Code selbst aber ist von Agenten erzeugt.
Amplitude hat einen sechsmonatigen Umbau seiner Entwicklungspipeline dokumentiert. Die Durchlaufzeit eines Pull Requests sank von 5,2 Stunden auf 44 Minuten, die Frontend-CI von rund dreißig Minuten auf drei bis vier.
Spotify betreibt einen im Hintergrund laufenden Coding-Agenten namens Honk und hat mehr als 1.500 KI-erzeugte Pull Requests dokumentiert, die in den Produktivbetrieb gemergt wurden.
Das sind außergewöhnlich leistungsfähige Entwicklungsorganisationen, ihre Erfahrungen taugen also nicht als Beleg dafür, dass jedes Unternehmen demnächst so arbeitet. Nützlich sind sie, weil sie weit genug gekommen sind, um die nächsten Engpässe freizulegen, und mehrere davon tauchen immer wieder auf.
In Amplitudes Entwicklungsumgebung hatten sich manuelle Einrichtung, langsame CI und uneinheitliche Werkzeuge angesammelt. Das hielt sich jahrelang, weil die Code-Erzeugung begrenzte, wie schnell Änderungen ins System gelangten. Agenten haben diese Drossel entfernt, und Validierung und Review wurden zu den Stellen, an denen es stockte.
Also hat Amplitude die Grundlagen neu gebaut: schnellere Einrichtung der Umgebung, drastisch schnellere CI und weniger uneinheitliche Muster, die Menschen wie Agenten verwirrten. Nur ein kleiner Teil dieser Arbeit war KI. Es war Infrastrukturarbeit, die nötig wurde, weil KI den Durchsatz des Systems verändert hatte.
Viele Organisationen sind derzeit damit beschäftigt, das beste Coding-Modell auszuwählen.
In der Praxis gilt: Eine CI-Pipeline von dreißig Minuten schlägt jedes Modell, das man darauf richtet.
Agenten beseitigen bestehende Engpässe im Engineering nicht. Sie legen sie schneller frei.
Drei Modi, keine Reifekurve
Die meisten Beschreibungen der KI-Einführung legen einen einzigen Weg nahe, von herkömmlicher zu vollständig autonomer Entwicklung. Ich glaube nicht, dass der Übergang im Unternehmen so verläuft. Drei Modi werden lange nebeneinander bestehen.
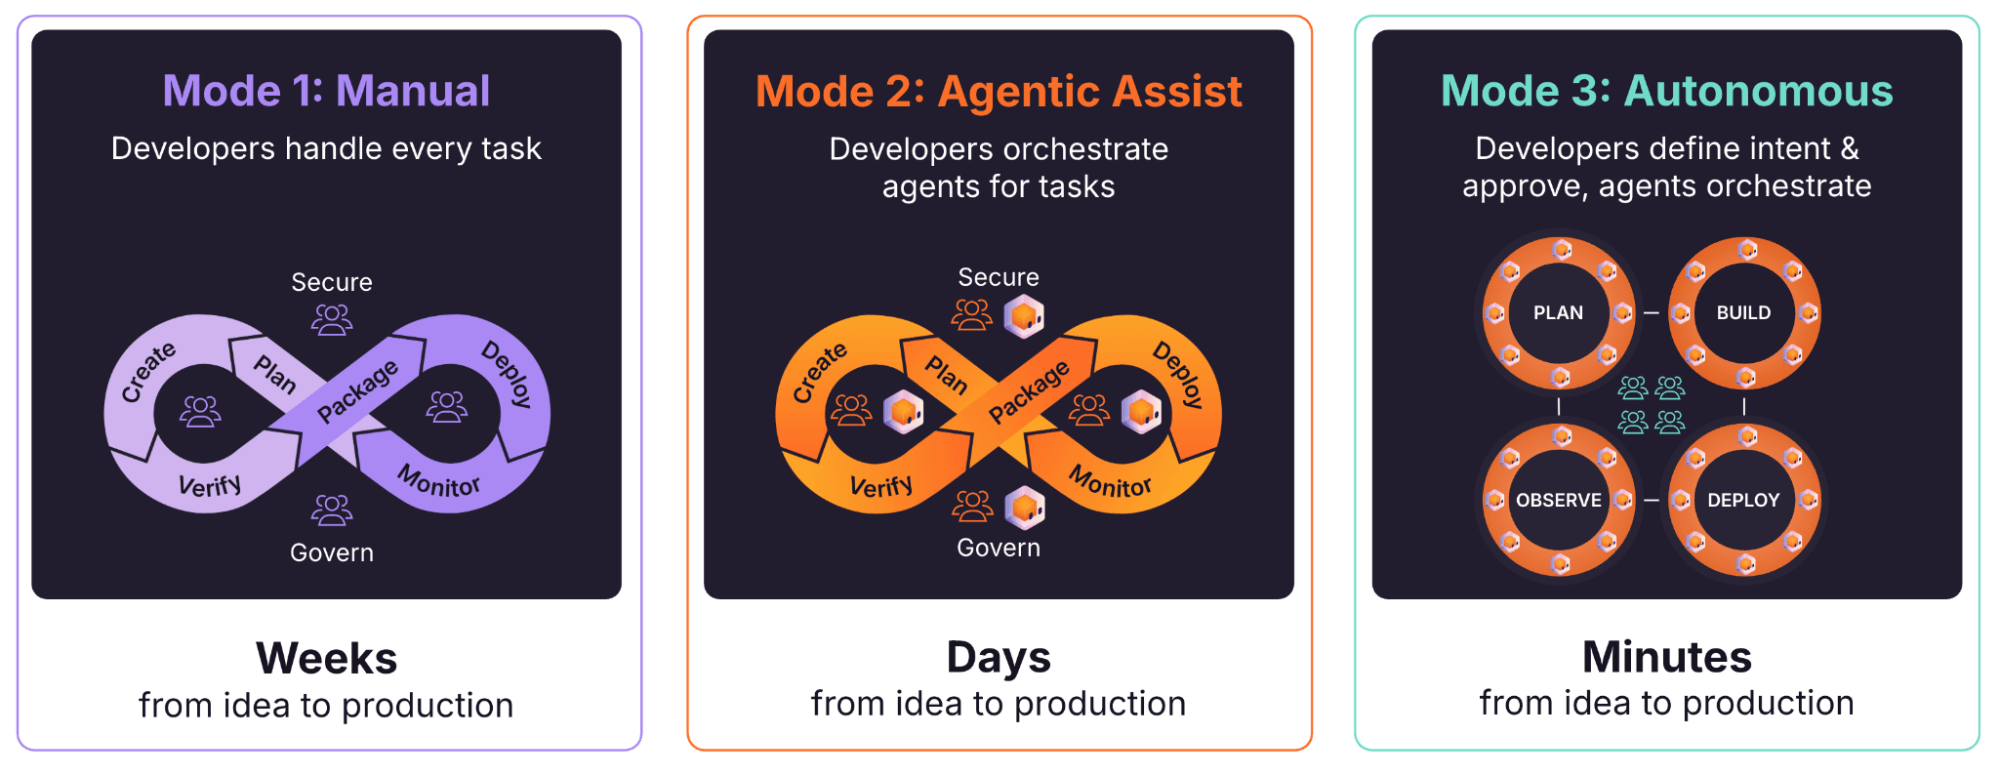
Modus 1: menschlich gesteuerte Altsysteme
Systeme mit undokumentierten Abhängigkeiten und Betriebswissen, das weiterhin in Menschen steckt. Viele davon bleiben weitgehend menschlich gesteuert, bis sie abgelöst oder neu geschrieben werden.
Modus 2: agentisch beschleunigte Entwicklung
Menschen behalten die Kontrolle, während Agenten bei Umsetzung, Tests, Migration, Review, Dokumentation und Sicherheitsanalyse zuarbeiten. Hier steht heute der größte Teil der Unternehmensentwicklung, und hier erwarte ich einen Großteil des kurzfristigen wirtschaftlichen Werts.
Das ist kein bloßer Warteraum für Autonomie. Eine der wertvollsten Verwendungen von Agenten könnte darin liegen, Modernisierungsprojekte wirtschaftlich zu machen, die sich vorher nicht rechtfertigen ließen.
Modus 3: autonome Entwicklung
Agenten führen die Umsetzungsschleife, Menschen geben Absicht, Leitplanken und Aufsicht vor. Die entscheidende Trennlinie verläuft nicht zwischen Neubau und Bestand. Sie verläuft danach, ob die Ausführung menschlich gesteuert bleibt oder sicher als geschlossene Schleife laufen kann.
Wo ein System steht, lässt sich mit drei Fragen bestimmen: Kann ein Agent mit dem verfügbaren Kontext eine brauchbare Änderung vornehmen? Lässt sich diese Änderung prüfen, ohne dass ein Mensch jede Zeile liest? Und wenn sie falsch ist, fängt das System sie ab, oder muss ein Mensch das tun? Je mehr diese Antworten von einem Menschen abhängen, desto näher bleibt die Aufgabe an Modus 1, unabhängig davon, wie leistungsfähig das Modell ist.
Jede Aufgabe zu früh in Modus 3 zwingen zu wollen, dürfte einer der teureren Fehler sein, die Organisationen in diesem Übergang machen können.
Die Pipeline führt die innere Schleife
Nachdem Amplitude die Frontend-CI unter fünf Minuten gedrückt hatte, war die entfernte Pipeline schnell genug, dass Entwicklungsteams viele Arbeiten parallel anstoßen und die Ergebnisse prüfen konnten, sobald sie zurückkamen.
Stripe ist von einer anderen Seite bei einer ähnlichen Architektur angekommen und gibt den Minions isolierte, vorgewärmte Entwicklungsumgebungen, damit viele Aufgaben gleichzeitig laufen können, ohne einander zu stören.
Die meisten Abläufe mit Coding-Agenten beginnen heute noch auf einem Laptop. Als Anfang ist das vernünftig. Dort endet die Architektur vermutlich nicht.
In einem agentischen System wird die Pipeline zum natürlichen Ort für die innere Entwicklungsschleife:
erzeugen → bauen → testen → validieren → prüfen → nachbessern → wiederholen
Der Agent arbeitet gegen diese Signale weiter, bis er etwas zurückgeben kann, das nicht nur plausibel aussieht, sondern funktionierende, verifizierte Software ist, die den Leitplanken der Organisation genügt.
Schnellere innere Schleifen erhöhen zugleich den Koordinationsbedarf. Tausend einzeln gültige Änderungen können ein System dennoch in widersprüchliche Richtungen ziehen. Je stärker KI die Abstände zwischen den Phasen des Lebenszyklus zusammendrückt, desto mehr muss die Abstimmung über die Absicht fortlaufend statt periodisch erfolgen.
Es gibt architektonische Gründe dafür, dass diese Schleife nahe am Repository und den umgebenden Systemen gehört.
Die Pipeline sitzt bereits neben Code, Build-System, Testinfrastruktur, Sicherheitskontrollen, Deployment-Konfiguration und einem großen Teil der Historie rund um eine Änderung. Je näher der Agent an diesen Systemen ist, desto weniger Kontext muss er über wiederholte entfernte Aufrufe und zersplitterte APIs rekonstruieren, und desto schneller bekommt er Rückmeldung. Das zählt, weil Entwicklung in Maschinengeschwindigkeit schon geringe Latenz und geringen Kontextverlust in Engpässe auf Systemebene verwandeln kann.
Die Schleife dort laufen zu lassen, bewahrt außerdem die Belege rund um die Arbeit. Die Identität, welche die Änderung angestoßen hat, die geltenden Richtlinien, die gelaufenen Tests, die erfolgten Reviews, die Nachbesserung des Agenten und das schließlich ausgelieferte Artefakt bleiben miteinander verbunden.
Das ist mehr als eine Frage der Effizienz. Es ist das, was wachsende Autonomie steuerbar macht.
Die Pipeline wandelt sich vom Tor am Ende der Entwicklung zu dem System, das die Entwicklungsschleife selbst führt.
Agentische Entwicklung skaliert deshalb dort am besten, wo Ausführung, Kontext und Governance nah an der Arbeit liegen. Je schneller ein Agent auf den richtigen Kontext zugreift, deterministische Rückmeldung erhält und belegen kann, was er getan hat, desto mehr der Schleife kann er sicher abschließen, bevor er die Arbeit an einen Menschen zurückgibt.
Die Frage lautet nicht mehr bloß: Ließ sich der Code kompilieren?
Sie lautet: War die Änderung tatsächlich gut, und können wir das belegen?
Autonomie wird gesteuert, nicht gewährt
Mit wachsender Leistungsfähigkeit der Modelle wird Governance meines Erachtens zunehmend zum begrenzenden Faktor für Autonomie.
Die ins Stocken geratenen Unternehmensprogramme, die ich gesehen habe, stocken selten daran, dass niemand ein Modell zum Erzeugen von Code bewegen könnte.
Sie stocken an grundlegenderen Fragen. Was darf der Agent? Wie belegen wir, was er getan hat? Wer trägt die Verantwortung, wenn er falschliegt?
Stripes Architektur zeigt das Muster. Minions verbinden offene Agentenschleifen mit deterministischer Software für Git, Linting und Tests. Sie laufen in isolierten Umgebungen, bestehen lokale Prüfungen vor dem Push und führen gezielt Tests aus einer Sammlung von mehr als drei Millionen Tests aus.
Der Agent darf kreativ sein.
Das System entscheidet, wo die Kreativität endet.
Amplitude nutzt ein Risikomodell, um zu unterscheiden, was automatisch gemergt werden kann und was weiterhin an einen Menschen gehen sollte.
Spotifys Verifikationsarchitektur gibt Agenten Zugang zur Verifikation, ohne die darunterliegende Umsetzung der Prüfer offenzulegen, und führt vorgeschriebene Prüfungen aus, bevor ein Pull Request überhaupt geöffnet werden kann.
Keine dieser Organisationen hat Verlässlichkeit mit einem besseren Prompt gelöst. Sie haben leistungsfähige Modelle mit deterministischen Toren, Isolation, Verifikation, Richtlinien und Belegen verbunden, und genau das erlaubt es, Autonomie sicher auszuweiten.
Es erklärt zugleich, warum das außerhalb der bestausgestatteten Technologieunternehmen schwerer wird. Die meisten Unternehmen werden weder ein eigenes Autorisierungsmodell für Agenten noch eine eigene Isolationsschicht, Verifikationsarchitektur und Belegführung erfinden wollen. Sie werden erwarten, vieles davon zu erben.
Das ist zunehmend gemeint, wenn wir bei GitLab von Tempo mit Kontrolle sprechen.
Tempo ohne Kontrolle endet irgendwann, weil die Organisation das Risiko nicht tragen kann. Kontrolle ohne Tempo lässt den Wert von KI ungenutzt. Beides muss gemeinsam entworfen werden.
Verantwortung kann klarer werden
Ein Einwand gegen autonome Entwicklung lautet, Verantwortung verschwinde in der Maschine. Das kann geschehen, wenn das System schlecht entworfen ist. Autonome Entwicklung kann Verantwortung aber auch ausdrücklicher machen, sofern Identität, Richtlinien, Kontext und Belege Teil der Ausführung bleiben.
Menschen bleiben dafür verantwortlich, die Leitplanken zu bestimmen: die Sicherheitsrichtlinie, den Performance-Schwellwert, die Compliance-Pflicht und das, was die Organisation aus dem letzten Vorfall gelernt hat. Die Steuerungsebene muss die Ausführung gegen diese Leitplanken belegbar machen.
Amplitudes Beschreibung seines Vorgehens für SOC 2 ist aufschlussreich. Der automatisierte Freigabeprozess stützt sich auf dokumentierte Kriterien, protokollierte Entscheidungen und einen Weg zum Übersteuern, statt für jede infrage kommende Änderung eine menschliche Freigabe zu verlangen. Der Mensch bewegt sich davon weg, jede Handlung freizugeben, und hin dazu, die Kriterien zu verantworten, unter denen Handlungen erlaubt sind. Das kann zugleich folgenreicher und besser prüfbar sein.
Die dauerhafte Schicht
Aus immer leistungsfähigeren Agenten ließe sich schließen, dass mehr des Software-Lebenszyklus im Modell aufgeht und alles ringsherum zur austauschbaren Infrastruktur wird.
Ich halte das Gegenteil für wahrscheinlicher.
Je mehr Agenten die Umsetzungsschleife übernehmen, desto wichtiger wird die dauerhafte Unternehmensschicht. Kontext, Identität, Richtlinien, Herkunftsnachweis, Verifikation und organisationales Gedächtnis können nicht allein in demjenigen Modell oder Agenten liegen, der die Arbeit gerade ausführt. Sie müssen über Modelle und Agenten hinweg Bestand haben.
Und mit der Zeit erwarte ich, dass der Produktentwicklungszyklus mehrere zweckgebaute Modelle nutzt.
Verschiedene Aufgaben werden auf unterschiedliche Ziele hin optimiert: Qualität des Schlussfolgerns, Latenz, Kosten, Sicherheit, fachliche Spezialisierung oder den Ort, an dem das Modell laufen kann. Manche werden Frontier-Modelle einsetzen. Andere kleinere oder Open-Weight-Modelle, näher an den Daten und der Infrastruktur der Kundschaft. Das beste Modell für die Planung muss nicht das beste für Code-Review, Sicherheitsanalyse, Tests oder Nachbesserung sein.
Das ist ein vertrautes Muster, wenn Technologien reifen. Eine einzelne Allzweckfähigkeit weicht einem spezialisierten Stack, der auf verschiedene Arbeitslasten hin optimiert ist.
In dieser Welt ist das Modell nicht die dauerhafte Architektur. Es ist eine Ausführungskomponente.
Je mehr Modelle und Agenten ein Unternehmen einsetzt, desto wertvoller werden der gemeinsame Kontext, die Kontrollen und die Historie um sie herum.
Das verschiebt auch die Grenze dessen, was wir bislang Software-Lebenszyklus genannt haben.
Der Lebenszyklus war um Menschen herum gebaut, die Arbeit durch eine Folge von Phasen schieben: planen, bauen, testen, absichern, ausrollen, betreiben. Je stärker KI diese Phasen zu fortlaufenden agentischen Schleifen zusammendrückt, desto mehr verwischt aus meiner Sicht der Unterschied zwischen dem Entwickeln von Software und dem Entwickeln des Produkts selbst.
Das entstehende Modell lässt sich als Produktentwicklungszyklus begreifen, kurz PDLC (Product Development Lifecycle): Geschäftliche Absicht tritt ins System ein, Agenten machen daraus Software, Verifikation und Governance entscheiden, was weitergehen darf, Ergebnisse aus dem Produktivbetrieb fließen in die nächste Entscheidung ein, und die Schleife läuft weiter.
In ausreichendem Maßstab sieht das weniger nach einem herkömmlichen Entwicklungsprozess aus und mehr nach einer Softwarefabrik: einem System, das Absicht und geschäftliche Signale fortlaufend in verifizierte Software verwandelt.
Eine Softwarefabrik ist aber nicht einfach eine Ansammlung autonomer Agenten. Die dauerhafte Schicht darunter ist es, die Kontext, Identität, Richtlinien, Belege und organisationales Gedächtnis bewahrt, während Modelle und Agenten wechseln.
Kontext und Herkunft
Anthropics AI-Native SDLC Playbook ist nützlich, weil es den Übergang greifbar macht. Es beschreibt, wie Absicht, Spezifikationen und Pläne zu maschinenlesbaren Artefakten werden und wie institutionelles Wissen Claude verfügbar gemacht wird. Dazu kommen Hooks und Skills, die Verhalten erzwingen, MCP, das Agenten mit Werkzeugen verbindet, und eine Versionshistorie, welche die Belege der Arbeit bewahrt. Das halte ich für brauchbare Muster, und viele Organisationen werden dort beginnen.
Unsere architektonische Wette bei GitLab lautet: Agentische Entwicklung verlangt eine neue Plattformarchitektur, nicht bloß ein besseres Modell.
Diese Architektur hat vier wesentliche Fähigkeiten: eine Agentenplattform, Ausführung im großen Maßstab, dauerhaften Kontext und Governance. Auf jede davon komme ich weiter unten zurück.
Unternehmen werden mehr als ein Modell einsetzen. Sie werden Agenten mehrerer Anbieter neben selbst gebauten Agenten nutzen. Und zunehmend werden sie eigene Agenten bauen wollen, die ihre Arbeitsabläufe, ihr Fachwissen und ihre Betriebsrichtlinien abbilden, neben den ausgezeichneten Agenten, die Anbieter weiterhin hervorbringen werden.
Die Plattform muss deshalb beide Wege tragen: Die Kundschaft soll die Agenten mitbringen können, die sie wählt, und Agenten bauen, anpassen und betreiben können, die ihr gehören.
Diese Agenten werden über Code, Planung, Sicherheit, CI, Deployment und Produktivsysteme hinweg handeln, oft gleichzeitig. Sie sollten nicht neu gebaut werden müssen, weil eine Organisation ihr bevorzugtes Modell oder ihre Cloud wechselt. Und Kontext, Richtlinien, Identität und Historie der Organisation sollten nicht demjenigen Modell-, Agenten- oder Infrastrukturanbieter ausgeliefert sein, der gerade in Mode ist.
Das Modell soll austauschbar sein. Der Agent soll der Kundschaft gehören. Gedächtnis und Kontrollen der Organisation sollen Bestand haben.
Deshalb geht der architektonische Druck aus meiner Sicht hin zu einer modell- und cloud-neutralen Plattform und nicht dahin, dass ein einzelnes Modell, ein Agentenanbieter oder eine Cloud zum führenden System wird.
Dafür muss nicht ein Anbieter jedes Artefakt besitzen, das bei der Entstehung von Software anfällt. Identität lässt sich föderieren. Ereignisse können zwischen Systemen wandern. Kontext lässt sich indexieren. Richtlinien lassen sich zentralisieren. MCP und andere offene Schnittstellen können Agenten Zugang zu Werkzeugen im ganzen Unternehmen geben. Viele Organisationen werden so bauen.
Das schwierigere Problem dabei ist, die Kette von Absicht über Handlung bis Ergebnis zu bewahren, während autonome Systeme in dieser Umgebung arbeiten.
Eine Anforderung autorisiert eine Änderung. Die Änderung läuft unter einer bestimmten Identität und einem bestimmten Richtlinienregime. Die Verifikation erzeugt Belege. Ein Deployment liefert sie aus. Der Produktivbetrieb erzeugt ein Ergebnis. Diese Beziehungen bilden einen kausalen Graphen.
Nichts davon ist neu. Neu ist die Häufigkeit, mit der diese Beziehungen erhalten bleiben müssen. Bei menschlicher Entwicklungsgeschwindigkeit ist es mühsam, aber oft verkraftbar, die Herkunft im Nachhinein über mehrere Systeme hinweg zu rekonstruieren.
Bei Maschinengeschwindigkeit wird Herkunft Teil des Ausführungspfads selbst.
Wenn die maßgeblichen Beziehungen von Haus aus in einem gemeinsamen System oder einer Steuerungsebene liegen, kann ein Agent unmittelbar über sie schließen. Liegen sie über mehrere Systeme verteilt, muss etwas sie rekonstruieren. Das ist möglich. Es erzeugt aber Arbeit rund um Identität, Synchronisation, Richtlinienkonsistenz, semantische Zuordnung und Belege. Bei maschinellem Volumen kann der Abgleich selbst zum Engpass des Systems werden.
Spotifys Erfahrung zeigt dasselbe Problem innerhalb einer Codebasis. In einer Migration stieß Honk auf mehrere Pipeline-Frameworks. Die stärker standardisierten ließen sich leichter automatisieren, Uneinheitlichkeit machte verlässlichen Kontext deutlich schwerer. Bei menschlichem Tempo erzeugt uneinheitlicher Kontext Reibung. Bei Maschinentempo verschlechtert er das Ergebnis immer wieder.
Die wichtige Einheit in autonomer Entwicklung ist zunehmend nicht das einzelne Artefakt. Es ist die Beziehung zwischen Absicht, Code, Richtlinie, Beleg, Deployment und Ergebnis.
Deshalb erwarte ich wachsenden Druck in Richtung einer gemeinsamen Steuerungsebene für die innere Entwicklungsschleife. Nicht weil ein einzelner Anbieter jedes Werkzeug besitzen müsste, sondern weil vertrauenswürdige Autonomie verlangt, dass diese Beziehungen zusammenhängend bleiben, während Maschinen in einem Maßstab handeln, den Menschen nie erreicht haben. Plattformen, die viele davon bereits halten, haben einen strukturellen Vorteil gegenüber Systemen, die sie nachträglich rekonstruieren müssen.
Datensätze statt Dateien
Eine sich abzeichnende Praxis in agentischer Entwicklung besteht darin, Absicht, Spezifikationen und Umsetzungspläne als Markdown-Dateien in ein Repository zu committen.
Der Instinkt gefällt mir. Absicht ausdrücklich, versioniert und für Menschen wie Agenten lesbar zu machen, schafft unmittelbar Wert.
Zwischen einer Datei und einem steuerbaren Datensatz besteht aber ein wichtiger Unterschied. Im Unternehmensmaßstab muss das System irgendwann Fragen beantworten, die eine Datei allein nicht beantworten kann:
- Wer darf das ändern?
- In welchem Zustand ist es?
- Wer hat es freigegeben?
- Welche Richtlinienversion galt?
- Welches Deployment ist daraus hervorgegangen?
- Wie frage ich zehntausend davon ab?
Teams können diese Fähigkeiten über Konventionen rund um Markdown nachbauen, doch genau daran haben führende Systeme jahrelang gearbeitet.
Die beste Architektur könnte Markdown als Schnittstelle zu Agenten anbieten und darunter einen strukturierten, steuerbaren Datensatz führen.
Die Schnittstelle darf einfach bleiben. Das System darunter nicht.
Agenten sollten der Organisation gehören
Agenten brauchen Kontext darüber, wie eine Organisation Software baut: Aufbau der Repositorys, Code-Konventionen, Build-Befehle, Testpraktiken, Architekturregeln und bekannte Fehlerbilder.
Spotify nennt diese Arbeit Context Engineering und hält sie für unverzichtbar, um über echte Codebasen hinweg verlässliche, merge-fähige Pull Requests zu erzeugen. Je mehr dieses Wissen wächst, desto mehr wird es zum Gut der Organisation.
Dasselbe gilt zunehmend für den Agenten selbst.
Ein Unternehmensagent kann über Jahre angesammelte Anweisungen, Arbeitsabläufe, Werkzeugzugriffe, Bewertungskriterien und Betriebsrichtlinien in sich tragen. Mit der Zeit kann daraus eines der wertvollsten geistigen Güter der Entwicklungsorganisation werden.
Es sollte der Organisation gehören und nicht einem Modellanbieter, Cloud-Anbieter oder einer proprietären Laufzeitumgebung.
Es gibt noch einen Grund, warum Eigentum zählt: Es erlaubt dem System, sich aufzubauen.
Jedes Mal, wenn ein Agent handelt, erzeugt die Organisation Belege darüber, was funktioniert hat und was nicht. Welche Änderungen wurden angenommen? Welche abgelehnt? Wo hat ein Mensch eingegriffen? Was ist im Produktivbetrieb gescheitert? Welche Leitplanke hat das Problem gefangen?
Über die Zeit bewahrt wird daraus ein internes Bewertungsset, das in der eigenen Codebasis und den eigenen Ergebnissen gründet und nicht in einem öffentlichen Benchmark. Die Organisation kann damit Modelle bewerten, ihre Agenten verbessern, deren Anweisungen und Abläufe nachschärfen und bestimmen, wo mehr Autonomie tatsächlich vertretbar ist.
Daraus entsteht eine Rückkopplung: Der Agent arbeitet, das System misst das Ergebnis, und was die Organisation daraus lernt, macht die nächste Agentengeneration besser in der Arbeit dieser Organisation.
Das führt den Gedanken weiter, dass aus Gelerntem Code wird. Aus Gelerntem können Tests und Richtlinien werden, ebenso aber Evals, Kontext und bessere Agenten.
Das ist kein Argument gegen einen bestimmten Anbieter. Wir bauen heute auf Anthropic-Modellen auf und erwarten, das weiterhin zu tun. Wer Claude Code einsetzt, soll das weiter tun können, mit demselben Unternehmenskontext, derselben Identität und demselben Audit-Trail wie bei jedem Agenten, den wir selbst bauen.
Der Punkt ist: Die Kundschaft muss ein Modell wählen, es wechseln, für verschiedene Aufgaben verschiedene Modelle einsetzen und ihre Agenten auf der Infrastruktur betreiben können, die das Geschäft verlangt. Und sie muss Agenten anderer Anbieter mitbringen und ihnen denselben Unternehmenskontext und dieselben Kontrollen geben können.
AGENTS.md ist ein Beispiel für ein offenes Format, das Coding-Agenten Projektanweisungen und Kontext bereitstellt. GitLab unterstützt es, und wir werden offene Formate wie dieses weiter unterstützen, weil das angesammelte Wissen einer Organisation übertragbar bleiben sollte, wenn sie Modelle, Agenten oder Anbieter wechselt.
Das Prinzip zählt mehr als der Dateiname.
Den Agenten besitzen. Seine Anweisungen besitzen. Den Kontext besitzen, aus dem er lernt. Modelle und Infrastruktur darunter eine Wahl bleiben lassen.
Alle können ausliefern
Eines der interessanteren Ergebnisse aus Amplitudes Erfahrung betraf nicht die Entwicklung. Nachdem das Unternehmen Einrichtung, Validierung und Review verbessert hatte, brachten Design, Produktmanagement und Marketing selbst Codeänderungen ein. Wer nicht aus der Entwicklung kam, ging von praktisch null Pull Requests auf rund fünf Prozent.
Das ist eine frühe Fassung einer Veränderung, die aus meiner Sicht deutlich größer wird. Wird Umsetzung billiger, verwischt die Grenze zwischen der Entscheidung, was gebaut wird, und dem Bauen selbst. Produktmanagement kann Absicht in laufende Software verwandeln. Design kann vom Prototyp zur Umsetzung gehen. Entwicklungsteams können auf einer höheren Abstraktionsebene über das Produkt hinweg arbeiten. Und Menschen außerhalb der klassischen Entwicklungsorganisation können zunehmend Lösungen unmittelbar aus dem Fachwissen bauen, das sie ohnehin haben.
Builder halte ich für eine brauchbare Bezeichnung dieser breiteren Rolle. Ein Builder kann aus Entwicklung, Design, Produktmanagement, Security, Marketing oder einer Fachdomäne kommen. Gemeinsam ist ihnen, dass sie Absicht ausdrücken, Agenten anleiten, das Ergebnis bewerten und aus einer Idee etwas Funktionierendes machen können.
Auch das gehört zur Verschiebung hin zum PDLC. Je stärker der Abstand zwischen Produktabsicht, Design, Umsetzung und Rückmeldung schrumpft, desto weniger ist Softwareentwicklung eine spezialisierte Übergabe innerhalb der Entwicklung und desto mehr eine fortlaufende Schleife des Produktbauens.
Das heißt nicht, dass Fachwissen verschwindet oder alle zu Entwicklerinnen und Entwicklern werden. Das Gegenteil könnte zutreffen. Je mehr Umsetzungsarbeit Agenten aufnehmen, desto wertvoller werden Fachwissen und Urteilsvermögen. Wer ein agentisches System beaufsichtigt, muss keine Entwicklungsleitung sein, die Coding-Agenten überwacht. Es kann jemand aus der Fachdomäne sein, der ausdrücken kann, was geschehen soll, und erkennt, ob das Ergebnis stimmt.
Am Ende steht eine viel größere Zahl von Menschen, die Software erschaffen können, ohne dass technisches Urteilsvermögen dadurch im Überfluss vorhanden wäre.
Knappe menschliche Aufmerksamkeit wandert nach oben: hin zu Absicht, Architektur, Leitplanken, schwierigen Abwägungen, Ausnahmen und der Bewertung, ob das System das Ergebnis erzeugt hat, das die Organisation tatsächlich wollte.
Die Arbeit des Softwarebauens weitet sich über die Entwicklung hinaus. Der Bedarf an Urteilsvermögen nicht.
Integration wandert nach außen
Nichts davon heißt, dass Integration ihre Bedeutung verliert. Ich erwarte, dass sich ihr Schwerpunkt verschiebt.
Innerhalb der hochfrequenten Ausführungsschleife wird engere Integration wertvoller, weil Agenten auf schnelle Rückmeldung, einheitliche Identität, gemeinsamen Kontext und durchsetzbare Richtlinien angewiesen sind.
Außerhalb dieser Schleife wird Integration noch wichtiger, weil die Absicht, die Software antreibt, zunehmend anderswo im Unternehmen entsteht.
Im Kundensupport steckt der Schmerz der Kundschaft. Im CRM stecken Zusagen. In Datenplattformen stecken Nutzung und geschäftliche Ergebnisse. Observability beschreibt den Zustand des Produktivbetriebs. Compliance-Systeme legen Pflichten fest. Diese Systeme liefern Signale, Absicht und Leitplanken, und die Steuerungsebene der Entwicklung macht daraus gesteuerte Handlung.
Mit der Zeit erwarte ich, dass der Abstand zwischen einem geschäftlichen Signal und einer Antwort in Software drastisch schrumpft.
Die wichtigste Entwicklungsplattform in dieser Welt wird sich deshalb womöglich weniger daran bemessen, wie viele Entwicklungswerkzeuge sie ersetzt, und mehr daran, wie gut sie gesteuerte Software-Ausführung mit den Systemen verbindet, die beschreiben, was das Geschäft braucht.
Die neue Plattformarchitektur
Diese Zukunft verlangt eine Plattformarchitektur, die um vier Fähigkeiten herum gebaut ist:
Agentenplattform: die Möglichkeit, Agenten zu erschaffen, anzupassen und zu betreiben, die der Organisation gehören, mit den Modellen und der Infrastruktur ihrer Wahl, und zugleich Agenten zu tragen, welche die Kundschaft von anderswo mitbringt.
Ausführung: Git der nächsten Generation, Artefaktverwaltung, CI/CD und die Fähigkeit, Software im menschlichen wie im maschinellen Maßstab zu bauen, zu testen, auszurollen und zu betreiben.
Kontext: ein zusammenhängendes Bild aus Anforderung, Code, Historie, geschäftlicher Priorität und Leitplanken rund um die Arbeit.
Governance: durchsetzbare Grenzen für Sicherheit, Compliance, Qualität, Identität und Berechtigungen, dazu die Sichtbarkeit, die Menschen brauchen, um zu verstehen, was Agenten getan haben, warum es erlaubt war und wo menschliche Aufmerksamkeit nötig ist.
Mit wachsender Autonomie geht es in der Governance weniger darum, jede Handlung freizugeben, und mehr darum, Menschen dabei zu helfen, die Ausnahmen zu verstehen und zu lenken. Richtlinien und Tests automatisieren Entscheidungen, welche die Organisation bereits getroffen hat. Die schwierigen Fälle sind die, mit denen niemand gerechnet hat.
Der letzte Engpass für Autonomie ist womöglich nicht, ob der Agent handeln kann. Es ist, ob ein Mensch verstehen und lenken kann, was Hunderte von Agenten gleichzeitig tun.
Diese vier Architekturschichten verstärken einander. Agenten handeln über die Ausführungsschicht. Ausführung erzeugt Signale, die den Kontext anreichern. Besserer Kontext macht Agenten leistungsfähiger und Governance genauer. Stärkere Governance erlaubt diesen Agenten größere Autonomie.
Unternehmen werden diese Fähigkeiten als zusammenhängende Plattform brauchen, auch wenn darunter viele verschiedene Modelle, Clouds, Produkte und Agenten mitwirken.
Was das in der Praxis bedeutet
Das sind nicht nur Architekturprinzipien für eine ferne autonome Zukunft. Sie verändern bereits, was wir bauen.
In Act 2 haben wir mehrere architektonische Wetten beschrieben, ausgehend von der Annahme, dass Softwareentwicklung zunehmend im Maschinenmaßstab abläuft. Auf GitLab Transcend im Juni haben wir die ersten Teile dieser Architektur gezeigt, jeweils mit Demos.
Die Kundschaft braucht einen Ort, um eigene Agenten zu bauen und zu betreiben. Die GitLab Duo Agent Platform ist unsere Plattform, um solche Agenten rund um die eigenen Arbeitsabläufe und das eigene Fachwissen zu erschaffen, anzupassen und zu betreiben. Die Modelle darunter lassen sich wählen, der Betrieb erfolgt auf der Infrastruktur, die das Geschäft verlangt, und externe Agenten lassen sich weiterhin daneben nutzen. Das Ziel ist nicht, jedes Unternehmen in ein einziges Agenten-Ökosystem zu zwingen. Es ist, der Kundschaft einen Ort zu geben, an dem sie Agenten bauen kann, die ihr gehören und die sie weiterentwickeln kann, ohne an ein einzelnes Modell oder eine einzelne Cloud gebunden zu sein.
Ausführung muss im Maschinenmaßstab laufen. Agenten klonen, verzweigen, wiederholen und stoßen Pipelines in Größenordnungen an, für die herkömmliche Versionsverwaltung nie entworfen wurde. Unsere Versionsverwaltung der nächsten Generation wird auf diese Wirklichkeit hin neu gebaut, unter anderem mit serverseitigen Zugriffsmustern, die einem Agenten erlauben, das zu holen, was eine Aufgabe tatsächlich braucht, statt wiederholt ein ganzes Repository zu bewegen. In internen Tests haben diese Änderungen die Ausführung von Aufgaben bis zu fünfzigmal beschleunigt und dabei deutlich weniger Daten bewegt.
Kontext muss zur Infrastruktur werden. GitLab Orbit verbindet Code, Work Items, Pipelines, Deployments und Signale aus dem Produktivbetrieb zu einem Kontextgraphen über den Software-Lebenszyklus. Agenten können diese Beziehungen unmittelbar abfragen, statt sie über Dutzende zusammenhangloser Aufrufe zu rekonstruieren. Wichtig dabei: Dieser Kontext ist nicht GitLabs eigenen Agenten vorbehalten. Agenten Dritter können dasselbe organisationale Gedächtnis nutzen.
Governance muss den Agenten umgeben, nicht in seinem Prompt stehen. Governance for Agents ist darauf ausgelegt, Identität, Richtlinien, Freigaben und Audit-Kontrollen um die Handlungen von Agenten zu legen, damit Organisationen Autonomie ausweiten können, ohne Belege und Verantwortlichkeit aufzugeben.
Das sind verschiedene Entwicklungsvorhaben, doch sie kommen aus derselben Voraussetzung:
Wird Umsetzung reichlich, muss die Plattform darunter Unternehmen erlauben, Agenten zu bauen und mitzubringen, und ihnen allen Ausführung, Kontext und Kontrolle im Maschinenmaßstab geben.
Was in den nächsten neunzig Tagen zu tun ist
Die Kosten pro akzeptierter Änderung messen. Die verstrichene Zeit von der erzeugten bis zur angenommenen Änderung erfassen und dann auf Umgebung, CI, Review, Nachbesserung und Governance aufteilen. Viele Teams werden feststellen, dass die Erzeugung bereits einen kleinen Teil des Ganzen ausmacht.
Die CI messen. Braucht eine vollständige Pipeline deutlich länger als fünf Minuten, kann deren Verbesserung mehr bewirken als ein Modellwechsel.
Die Kriterien aufschreiben, nicht nur die Freigaben. Eine Klasse risikoarmer Änderungen aussuchen und festlegen, was sie ohne menschliche Freigabe merge-fähig machen würde. Das ist der Anfang ausführbarer Governance.
Kontext übertragbar machen. Repository-Anweisungen und Betriebswissen in einem offenen, versionierten Format ablegen, das Menschen wie Agenten nutzen können.
Entscheiden, welche geschäftlichen Signale unmittelbar in die Entwicklungsschleife gelangen sollen. In Support, Observability und Compliance-Systemen stecken zunehmend Absicht und Leitplanken. Festlegen, welche Signale zu gesteuerter Entwicklungsarbeit werden sollen, ohne dass sie jemand abtippen muss.
Wie es weitergeht
Die Erzeugung von Code wird zunehmend zur Massenware. Das heißt nicht, dass Softwareentwicklung kostenlos wird. Es heißt, dass sich die Ökonomie verändert.
Die brauchbare Einheit sind nicht die Kosten pro Codezeile.
Es sind die Kosten pro akzeptierter Änderung.
Je billiger die Erzeugung wird, desto wichtiger wird anteilig alles um sie herum: Umgebung, Kontext, Verifikation, Governance und Belege.
Das verschiebt auch, wohin knappes menschliches Urteilsvermögen fließt. Technisches Urteilsvermögen wird nicht deshalb reichlich, weil Umsetzung es wird. Menschliche Aufmerksamkeit wandert nach oben: hin zu Architektur, Absicht, Leitplanken, schwierigen Ausnahmen und der Bewertung, ob das System das Ergebnis erzeugt hat, das die Organisation wollte.
Und es verschiebt, wo aus meiner Sicht strategischer Wert im Stack der Softwareentwicklung entsteht. Sechzig Jahre lang war Umsetzung so knapp, dass sich Software-Engineering weitgehend darum drehte, Entwicklungskapazität zu schützen und Änderungskosten zu begrenzen. KI verändert diesen Engpass.
Wird Umsetzung reichlich, wird Vertrauen knapp.
Vertrauen verlangt mehr als ein Modell, das eine plausible Antwort liefert. Es verlangt Belege, dass die Software unter den richtigen Leitplanken entstanden ist und sich so verhalten hat, wie die Organisation es beabsichtigt hat. Unternehmen können diese Fähigkeiten aus vielen Produkten zusammensetzen, und viele werden das tun. Doch mit zunehmender maschineller Aktivität erzeugen zersplitterte Steuerungsebenen ein immer teureres Abgleichsproblem.
Der architektonische Druck geht deshalb nicht zwingend dahin, dass ein Anbieter alles besitzt.
Er geht hin zu einer modell- und cloud-neutralen Plattform, auf der Unternehmen die Agenten mitbringen können, die sie wählen, Agenten bauen und anpassen können, die ihnen gehören, und ihnen allen eine gemeinsame Schicht aus Ausführung, Kontext und Governance geben können.
Darin sehen wir die Gelegenheit für GitLab.
Das Modell kann wechseln. Die Cloud kann wechseln. Der Agent kann von einem Anbieter kommen oder von der Kundschaft gebaut sein.
Die Intelligenz, der Kontext und die Kontrollen der Organisation müssen sie alle überdauern.
Stripe, Spotify und Amplitude haben gezeigt, was außergewöhnliche Entwicklungsorganisationen für sich selbst bauen können. Anthropics Playbook zeigt nun, wie schnell sich das Betriebsmodell rund um Softwareentwicklung zu verändern beginnt. Die meisten Unternehmen haben kein Plattformteam zur Verfügung, das diese Maschinerie von Grund auf nachbauen könnte. Sie werden vieles davon erben müssen.
Software-Engineering hat sechzig Jahre lang eine knappe Ressource geschützt. Es wird das nächste Jahrzehnt damit verbringen, eine reichlich vorhandene zu steuern.
Das ist das bessere Problem.
Quellen
- GitLab, GitLab Act 2, 11. Mai 2026. about.gitlab.com/blog/gitlab-act-2
- GitLab, Built for the agentic engineering era, 10. Juni 2026, mit Demo-Videos von GitLab Transcend. about.gitlab.com/de-de/blog/gitlab-transcend-announcements
- Anthropic, The AI-Native SDLC Playbook, 21. August 2026. claude.com/blog/the-ai-native-sdlc-playbook
- Amplitude EPD, Speedrunning Software: How We 3×'d PRs in 6 Months. amplitude.com/3x
- Stripe, Minions: Stripe's one-shot, end-to-end coding agents. Teil 1 und Teil 2
- Spotify Engineering, Background Coding Agents. Teil 1, Teil 2, Teil 3, Teil 4
AGENTS.md, ein offenes Format zur Anleitung von Coding-Agenten- Goldratt, Theory of Constraints. tocinstitute.org
Weitere Inhalte
Alle Blogbeiträge anzeigen
Feedback erwünscht
Hat dir dieser Blogbeitrag gefallen? Hast du Fragen oder Feedback? Erstelle ein neues Diskussionsthema im GitLab-Community-Forum und lass andere an deinen Eindrücken teilhaben.
Feedback teilen