Date de publication : 5 octobre 2026
Temps de lecture : 8 min
Git a été pensé pour les humains, il est temps de l'adapter aux agents
Découvrez comment la gestion du code source de nouvelle génération de GitLab s'adapte aux agents, et pourquoi un nouveau backend doit répondre aux défis liés à la traçabilité et au cycle de vie.
Le secteur s'emploie à reconstruire la gestion du code source à destination des agents. Nous avons présenté notre vision lors de notre événement GitLab Transcend en juin dernier, mais il convient de rappeler pourquoi repenser le backend Git ne représente qu'une partie du problème.
Trois problèmes apparaissent lorsque les agents deviennent les principaux utilisateurs d'un serveur Git. Tout développeur gérant des centaines d'agents se heurte au même obstacle, quels que soient les outils utilisés :
- Le coût du clonage. Un agent clone l'intégralité d'un dépôt pour lire un seul fichier, puis recommence pour l'agent suivant et pour chaque nouvelle tentative, transférant ainsi bien plus de données que la tâche ne l'exige et consommant du contexte pour un grep ou un blame local qu'il n'aurait pas dû avoir besoin d'exécuter. Aujourd'hui, une seule invocation d'agent peut représenter entre 5 et 10 Go de données transférées et plus de 30 secondes de configuration, simplement pour répondre à une question.
- L'effondrement de la simultanéité. Des milliers de sessions sollicitent un backend initialement conçu pour un usage humain, générant des goulots d'étranglement et une disponibilité imprévisible.
- L'absence d'isolation. Les agents partagent des comptes et un espace de branches commun. Ils saturent ainsi le dépôt, n'offrent aucun moyen propre d'éliminer une tâche abandonnée et ne conservent aucune trace de l'action de chaque agent.
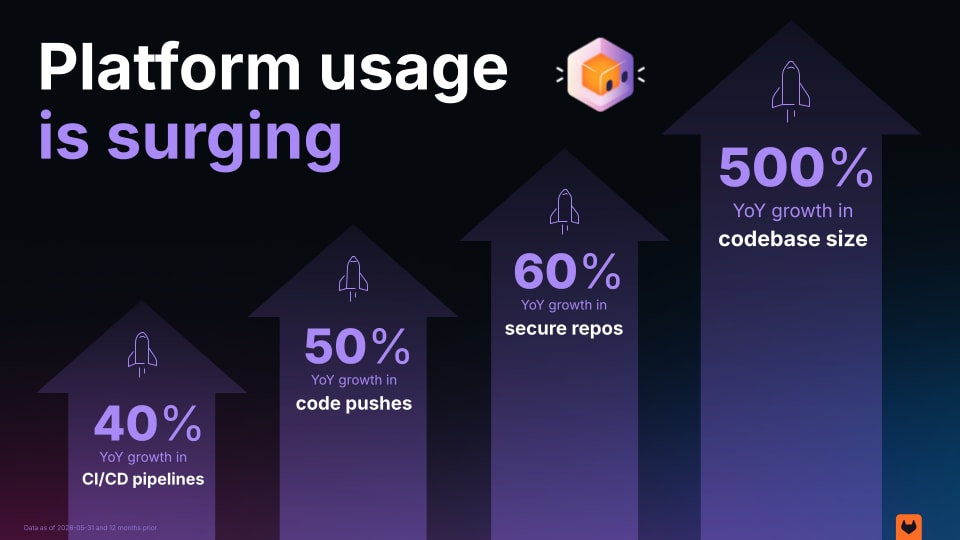
Les données de notre plateforme illustrent la rapidité avec laquelle la pression s'intensifie. Au cours de l'année écoulée, nos clients ont créé 40 % de pipelines CI/CD supplémentaires, et les push de code vers GitLab.com ont augmenté de 50 %. Alors que les dépôts sécurisés ont augmenté de 60 %, la taille des codes sources a elle aussi connu une croissance allant jusqu'à 500 %.
Lorsque nous avons annoncé la gestion du code source de nouvelle génération (SCM de nouvelle génération) en juin dernier lors de notre événement GitLab Transcend, nous avons expliqué pourquoi Git, en tant que modèle opérationnel, n'avait pas été conçu pour supporter la charge imposée par les agents. Quelques semaines plus tard, de nouveaux acteurs, notamment des hébergeurs Git conçus spécifiquement pour la simultanéité à l'échelle des agents, ont confirmé cette affirmation de manière indépendante. Cette convergence met en évidence la nécessité de repenser le backend Git, mais cela ne suffit pas à lui seul.
Ce que nous construisons pour les agents
La gestion du code source de nouvelle génération repose sur le protocole Git pour assurer la rétrocompatibilité, avec un backend et des interfaces repensés pour les agents. Plutôt que de cloner un arbre de travail complet, les agents interrogent le dépôt côté serveur pour obtenir exactement ce dont une tâche a besoin, chaque agent étant limité à la visibilité minimale nécessaire à sa tâche. La compatibilité Git et la traçabilité sont préservées, avec un moteur sous-jacent différent.
L'architecture sépare une couche d'intelligence (routage, mise en cache, tâches en arrière-plan) d'un calcul élastique qui s'adapte à la demande et d'un stockage d'objets élastique. Des API de lecture et d'écriture dédiées permettent aux agents de récupérer les données des fichiers, des blames et des historiques, et de valider des modifications sans avoir à télécharger l'intégralité du dépôt. Les équipes de développement peuvent exécuter des agents sur n'importe quel dépôt, les déployer par milliers et leur permettre d'expérimenter en toute sécurité. En pratique, un agent effectue une lecture par lot unique au lieu d'un clone complet, une requête diff-stat au lieu d'un clone suivi d'un diff, et une recherche du dernier commit pour un chemin donné au lieu d'un clone suivi d'un blame.
Cette architecture ne se limite pas au cloud. Les couches de calcul et de stockage communiquent via l'API S3 standard, de sorte que la même architecture qui fonctionne sur GitLab.com peut être déployée sur l'infrastructure d'un client, qu'il s'agisse du stockage objet d'un grand fournisseur cloud ou d'un système compatible S3 auto-hébergé dans le centre de données du client. Pour les environnements air-gapped, réglementés ou soumis à des contraintes de souveraineté, cela signifie les mêmes garanties de mise à l'échelle horizontale et de cohérence, sans que les données du dépôt ne quittent l'infrastructure contrôlée par le client.
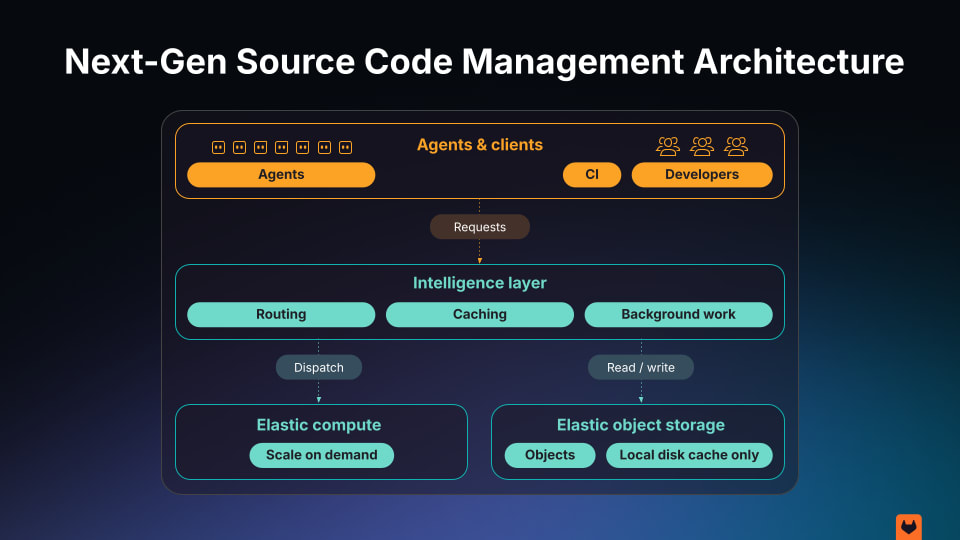
Lors des premiers tests internes, les agents opérant sur la gestion du code source de nouvelle génération ont enregistré :
- Jusqu'à 50 fois moins de temps d'exécution
- Jusqu'à 2 fois moins de tokens
- Jusqu'à 1 000 fois moins de trafic réseau
Ces chiffres représentent des plafonds, et non des garanties, mesurés en fonction de nos propres conditions de test. La charge de travail qui sollicite réellement un backend Git à l'échelle des agents consiste en des lectures et écritures simultanées effectuées par de nombreux agents indépendants sur les mêmes dépôts, maintenues sous charge. Ainsi, un chiffre n'a de sens que si le test se rapproche de cet objectif, si le générateur de charge ne constitue pas un goulot d'étranglement, et si la distribution complète de la latence est communiquée.
Nous appliquons ces exigences à nos propres résultats, et nous encourageons quiconque évaluant cette catégorie à poser ces mêmes questions pour chaque chiffre qui lui est présenté, y compris les nôtres. Ces exigences sont intégrées à l'architecture elle-même, et pas seulement à nos conditions de test. La maintenance du stockage compacte les petits artefacts en artefacts plus volumineux et figés selon un calendrier géométrique, ce qui impose un plafond strict à la quantité de données qu'un nœud doit récupérer pour se mettre à jour avec le dernier instantané. Avec un seuil de gel de 1 Go et un taux de compaction de 2x, ce plafond est de 2 Go, quelle que soit la taille atteinte par le dépôt.
La gestion du code source de nouvelle génération est désormais disponible en version bêta privée. Voici une démonstration en action :
Reconstruire le backend ne représente que la moitié du problème
Les nouveaux acteurs développent des hébergeurs Git : des destinations autonomes ou des miroirs rapides placés en amont d'un hébergeur existant pour absorber le trafic de lecture. Cette approche résout le problème de la simultanéité, qui est bien réel. Mais deux questions restent sans réponse, et toutes deux sont au cœur de notre vision de l'infrastructure agentique de GitLab.
La première concerne la traçabilité. Lorsque les agents effectuent un push du code, modifient des dépendances et déclenchent des déploiements par centaines, la question ne porte plus sur « Avons-nous effectué un scan ? » mais sur « Quel agent a fait quoi, sous quelle politique, et pouvons-nous le prouver ? » Nos API d'agents attribuent chaque action d'agent à un workflow, un modèle et un token spécifiques. Chaque opération d'agent est acheminée via les mêmes contrôles d'autorisation de projet et de supervision humaine selon la portée du rôle qui régissent déjà les contributeurs humains. L'attribution et la politique sont des propriétés de la plateforme, et non des fonctionnalités du dépôt, et un hébergeur Git autonome n'est pas conçu pour répondre à cette question nativement.
La seconde concerne ce qu'il advient des tâches une fois qu'elles ont abouti. Une expérience d'agent réussie vit sur un hébergeur autonome. Sur GitLab, la gestion du code source de nouvelle génération est un backend Git intégré à une plateforme qui gère déjà l'intégration continue, la gestion des politiques, les contrôles de gouvernance et l'audit du code produit. Lorsque l'expérience éphémère d'un agent fonctionne, elle s'intègre directement dans un pipeline de production gouverné et observable, sans nécessiter de plateforme ou de destination distincte.
La gestion du code source de nouvelle génération gère l'exécution à l'échelle des agents. GitLab Orbit fournit à chaque agent et à chaque individu une vision complète de l'ensemble du cycle de vie logiciel sous forme de graphe de connaissances, tandis que GitLab Duo Agent Platform orchestre la gouvernance et la sécurité autour de chaque action des agents, afin qu'ils puissent planifier et exécuter des tâches tout au long du SDLC, et pas seulement dans le cadre des opérations Git. Un backend Git plus rapide héberge le code généré par les agents. Associé à la gouvernance, au contexte et à l'orchestration de GitLab, ce code emprunte le même chemin d'intégration continue, de politique et d'audit que tout le reste de la plateforme.
Toutes les entreprises se heurteront à cet obstacle
Tous les clients utiliseront des agents pour le développement, et tous ceux qui les déploieront à grande échelle rencontreront les mêmes limites décrites ci-dessus, quels que soient les modèles ou les outils qu'ils auront choisis comme standard. C'est ce qui fait de cette évolution une transformation au niveau de la couche d'infrastructure. Les équipes qui progresseront le plus rapidement à l'ère agentique seront celles capables d'héberger, de gouverner et de réintégrer les données de sortie des agents dans un cycle de vie déjà conçu pour livrer des logiciels fiables.
Premiers pas
La gestion du code source de nouvelle génération est disponible en version bêta privée. Demandez un accès anticipé dès aujourd'hui !
En savoir plus
Afficher tous les articles du blog
Donnez-nous votre avis
Cet article de blog vous a plu ? Vous avez des questions ou des retours ? Donnez votre avis en créant un nouveau sujet sur le forum de la communauté GitLab.
Faites-nous part de vos commentaires